cogvideox — テキストと画像から動画を生成
を閲覧する サンプルシーン または プロジェクトリソース.
プロジェクトの更新
- 🔥🔥 ニュース:
2025/03/24— CogKitは、CogView4およびCogVideoXモデルファミリー向けのファインチューニングと推論ツールを統合します。 - 🔥 ニュース:
2025/02/28— CogVideoX-5BおよびCogVideoX1.5-5BにDDIM Inverseのサポートが追加されました。 - 🔥 ニュース:
2025/01/08— DiffusersベースのLoRAファインチューニングコードが、より少ないメモリで実行できるワークフローに更新されました。 - 🔥 ニュース:
2024/11/15— CogVideoX1.5がDiffusers版で利用可能になり、以前のコードにはわずかな変更のみが必要です。 - 🔥 ニュース:
2024/11/08— CogVideoX1.5では、高解像度、10秒間の生成、さまざまな解像度での画像から動画への変換に対応し、シリーズが拡張されました。 - 🔥 ニュース:
2024/10/13— 複数の解像度に対応したCogVideoX-5B向けの単一GPUファインチューニングフレームワークがリリースされました。 - 🔥 ニュース:
2024/10/10— 技術レポートが更新され、さらなるトレーニングの詳細とデモンストレーションが追加されました。 - 🔥 ニュース:
2024/09/19— CogVideoX-5B-I2Vにより、テキストから動画への変換や動画の続きを生成する機能に加えて、画像条件付き動画生成がシリーズに追加されました。 - 🔥
2024/09/19— CogVLM2-Caption(トレーニング中の動画データの説明に使用)がリリースされました。 - 🔥
2024/08/27— より大規模なモデルを利用しやすくするための推論最適化を施した cogvideox-5B がリリースされました。 - 🔥
2024/08/06— 3D因果VAEと、初の cogvideox-2B モデルがオープンソース化されました。 - 🌱 以前の研究: CogVideoのテキストから動画を生成する研究では、動画生成に向けた大規模なTransformerベースのアプローチが初めて導入されました。
目次
特定のセクションに移動:
クイックスタート
プロンプトの最適化
cogvideox は詳細な説明を用いてトレーニングされています。明確で具体的なプロンプトは、生成される動画に大きな違いをもたらします。モデルを実行する前に、被写体、環境、動作、照明、カメラの動きを記述してください。
SAT
ドキュメントに記載されたワークフローでは、Python 3.10から3.12を使用してください。
SATの実装には、SATモデルの重みを使用した推論およびファインチューニングの例が含まれています。モデル構造を適応させる研究者向けの出発点として設計されています。
Diffusers
ドキュメントに記載されているワークフローでは、Python 3.10から3.12を使用してください。
pip install -r requirements.txtDiffusersの推論例では、一般的な生成パラメータについて説明しています。DiffusersとTorchAOを使用した量子化推論により、必要なメモリ量を削減できますが、実際の性能はハードウェアと構成によって異なります。
ギャラリー
CogVideoX-5B
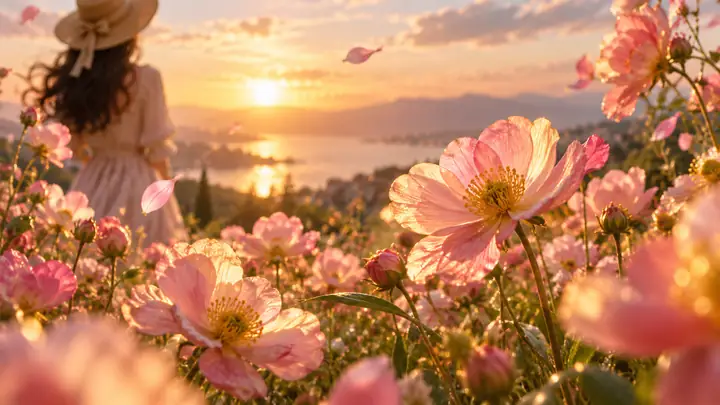
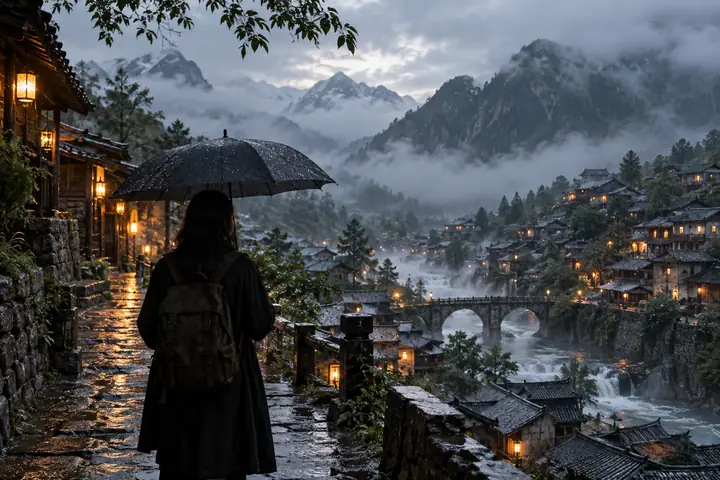
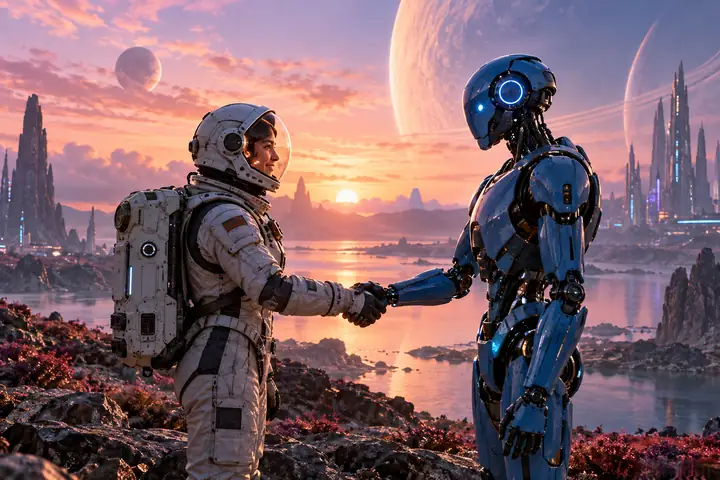
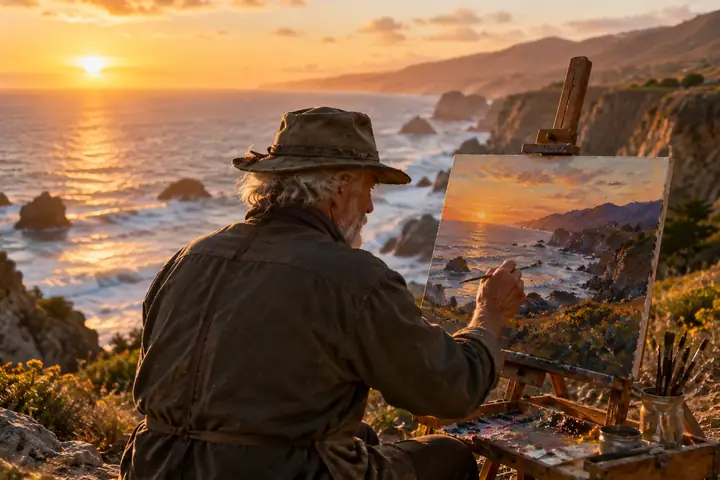
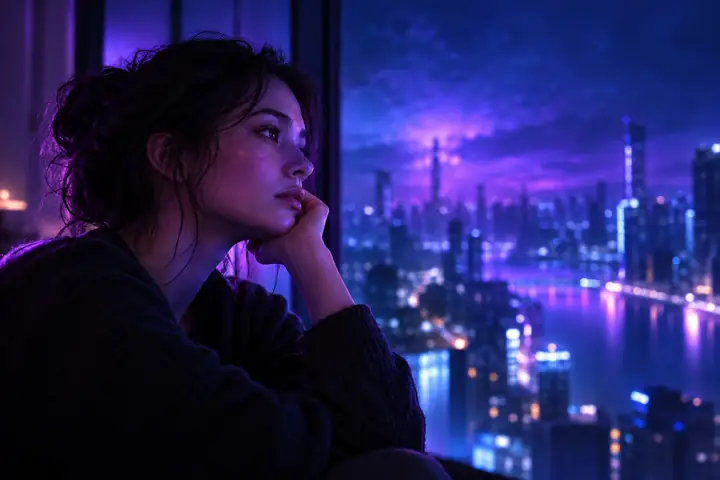
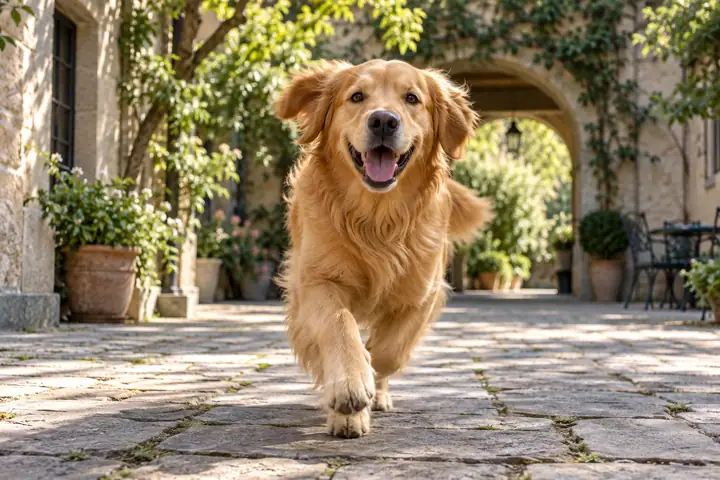
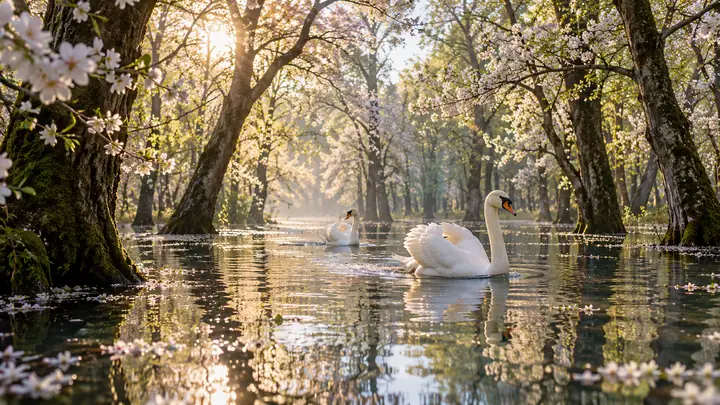
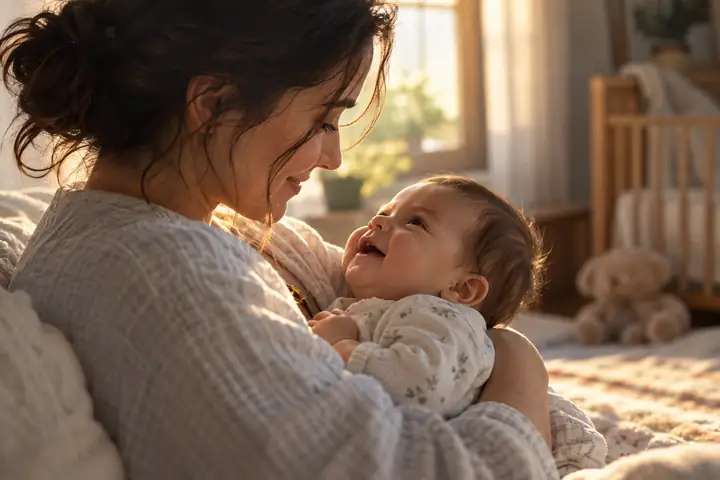
CogVideoX-2B
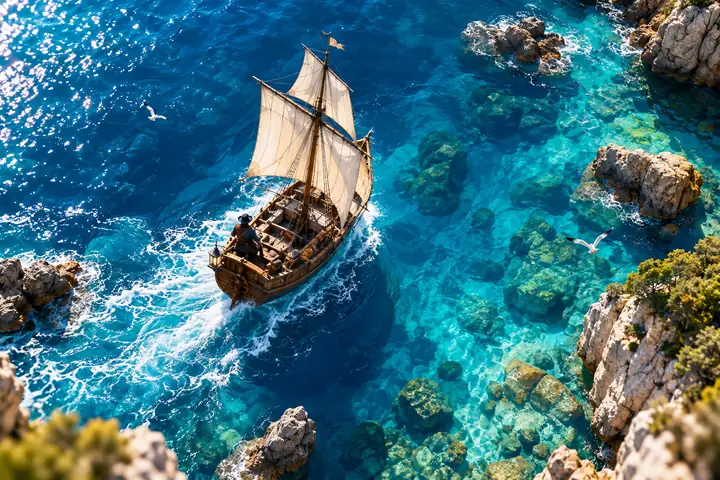
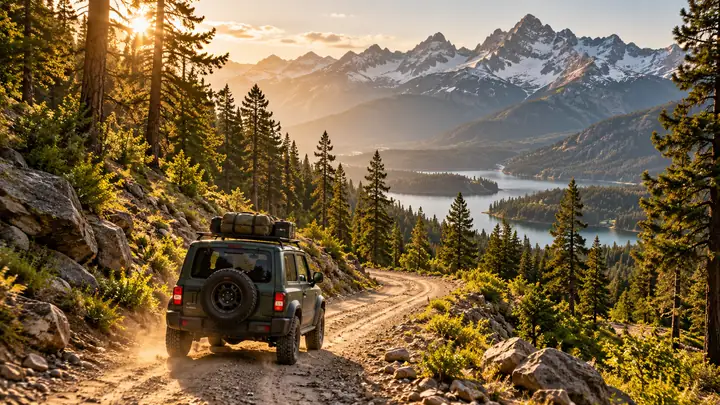
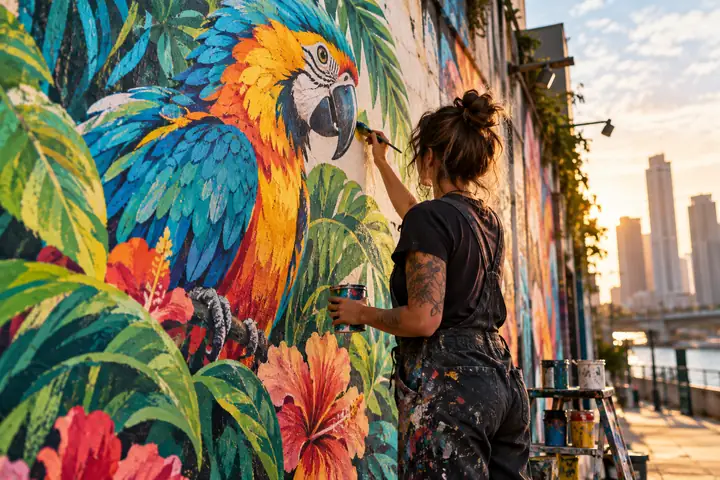
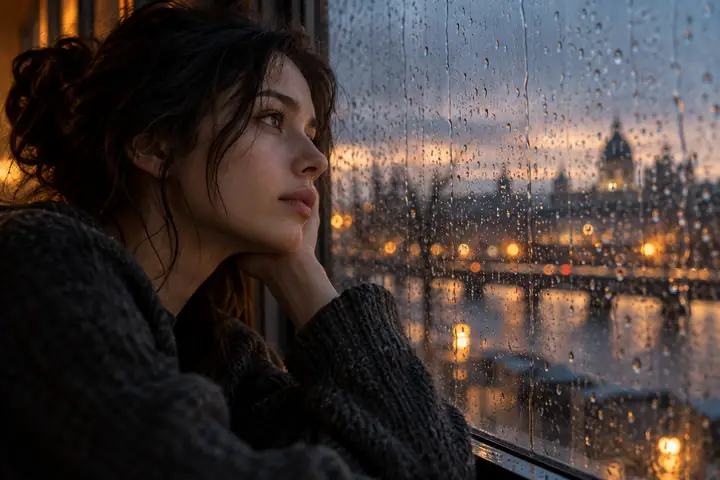
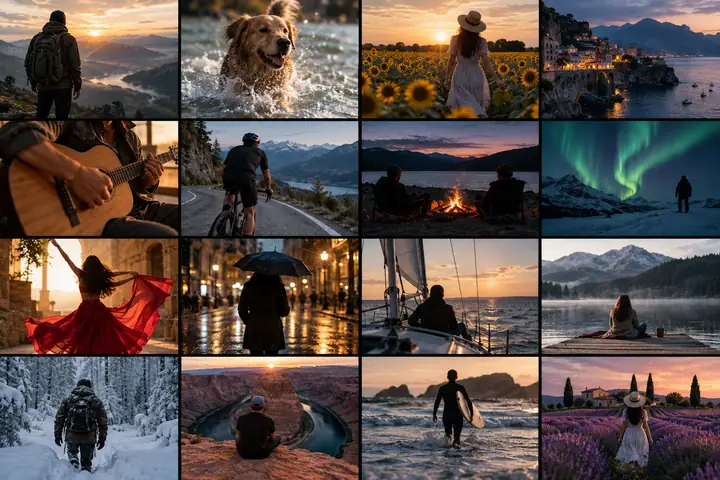
これらの静止画は、モデルギャラリーで扱われているさまざまなシーンの例を示しています。
モデル紹介
cogvideoxは、オープンソースの動画生成モデルファミリーです。以下の概要では、公開されている各バリエーションと基本的な生成特性を比較します。
| モデル名 | CogVideoX1.5-5B | CogVideoX1.5-5B-I2V | cogvideox-2B | cogvideox-5B |
|---|---|---|---|---|
| 公開日 | 2024年11月8日 | 2024年11月8日 | 2024年8月6日 | 2024年8月27日 |
| 動画の解像度 | 1360 × 768 | 文書に記載された制限内で可変の寸法 | 720 × 480 | 720 × 480 |
| フレーム数 | 16N + 1; デフォルトは81 | 16N + 1; デフォルトは81 | 8N + 1; デフォルトは49 | 8N + 1; デフォルトは49 |
| 推論精度 | BF16を推奨 | BF16を推奨 | FP16を推奨 | BF16を推奨 |
| 単一GPUのメモリ | 実装と最適化によって異なります | 実装と最適化によって異なります | 実装と最適化によって異なります | 実装と最適化によって異なります |
| 複数GPUの使用 | 対応するワークフローでサポート | 対応するワークフローでサポート | ワークフローによって異なる | ワークフローによって異なる |
| プロンプトの言語 | 英語 | 英語 | 英語 | 英語 |
| プロンプトのトークン数上限 | 224 tokens | 224 tokens | 226 tokens | 226 tokens |
| 動画の長さ | 5または10 seconds | 5または10 seconds | 6 seconds | 6 seconds |
| フレームレート | 16 frames / second | 16 frames / second | 8 frames / second | 8 frames / second |
| 位置エンコーディング | 3d_rope_pos_embed | 3d_rope_pos_embed | 3d_sincos_pos_embed | 3d_rope_pos_embed |
| モデルを探す | モデルオプション | 画像から動画へのオプション | モデルオプション | モデルオプション |
データの説明
- 公開されているメモリ使用量の数値は、実装、デバイスアーキテクチャ、精度、有効化されている最適化によって異なります。すべてのGPUでの保証値として扱わないでください。
- CPUへの逐次オフロード、VAEスライシング、VAEタイリングによりピークメモリ使用量を削減できますが、速度が低下する可能性があります。
pipe.enable_sequential_cpu_offload()
pipe.vae.enable_slicing()
pipe.vae.enable_tiling()- マルチGPU推論には専用の設定が必要です。この構成ではCPUへの逐次オフロードは使用されません。
- INT8推論はメモリ容量の少ないデバイスにも対応できますが、実行速度が遅くなる場合があります。
- cogvideox-2BはFP16で、5BバリアントはBF16で学習されています。
- 量子化ツールを使用すると、テキストエンコーダー、トランスフォーマー、VAEに必要なメモリを削減できます。結果はハードウェアによって異なります。
- 記載されている推論プロンプトは英語です。他言語のプロンプトは、使用前に翻訳できます。
関連リンク
コミュニティプロジェクトでは、cogvideoxを中心に、アクセラレーション、長時間動画、代替インターフェース、デプロイ、ファインチューニングなどが検討されています。ここでは、そのエコシステムで行われている取り組みの一部を紹介します。
- LeMiCa: キャッシュベースの拡散推論高速化。
- RIFLEx-cogvideox: 生成動画の長さを拡張する手法。
- cogvideox-Fun: 柔軟な解像度と起動方法に対応するパイプライン。
- CogStudio: 独立したGradio風のウェブインターフェース。
- Xorbits Inference: 分散モデルデプロイワークフロー。
- ComfyUI-CogVideoXWrapper: ノードベースのワークフローへの統合。
- VideoSys: 動画生成パイプライン向けのインフラストラクチャ。
- AutoDL Space: コミュニティによるデプロイ例。
- Interior Design Fine-Tuning Model: ドメイン特化型のファインチューニング版。
- xDiT: 複数のGPUにまたがるスケーラブルな推論。
- CogVideoX-Interpolation: キーフレーム補間の実験。
- DiffSynth-Studio: 拡散ワークフローエンジン。
- CogVideoX-Controlnet: 制御に特化したコミュニティモジュール。
- VideoTuna: 動画生成モデルのワークフロー集。
- ConsisID: 生成動画におけるID一貫性の研究。
- ステップバイステップのチュートリアル: インストールと最適化の手順。
プロジェクト構成
このオープンソースプロジェクトでは、cogvideoxモデルファミリーの基本的な使用方法、推論、モデル変換、ファインチューニングの例を整理しています。
Colabですぐに始める
サンプルノートブックでは、いくつかの開始方法を紹介しています。
- cogvideox-5Bによるテキストから動画への生成。
- 量子化されたテキストから動画への推論。
- cogvideox-5Bによる画像から動画への生成。
- cogvideox-5Bによる動画から動画へのワークフロー。
推論
- CLIデモ: 一般的な生成パラメータとコマンドライン推論の例。
- 量子化デモ: 低メモリモデルの推論設定。
- VAEデモ: 動画オートエンコーダーを個別に実行します。
- Spaceデモ: フレーム補間と超解像のワークフローをオプションで利用できるインターフェース。
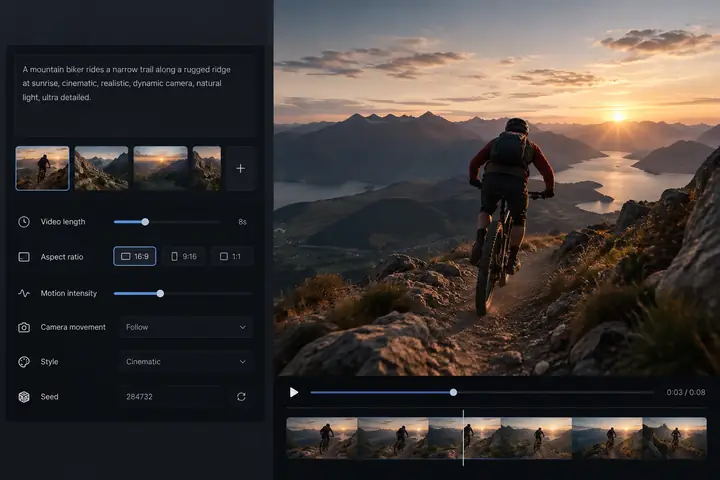
- プロンプト変換: 短いユーザー入力を、モデルに適した長い説明へと拡張します。
- Webデモ: 動画生成を試せるシンプルなブラウザーインターフェース。
ファインチューニング
- ファインチューニングの例では、Diffusersベースのcogvideoxワークフローについて説明しています。
sat
- SATフォルダーには、研究者向けのモデル重み推論とファインチューニングの例が含まれています。
ツール
サポートツールには、モデル変換、キャプション生成、アダプター管理、並列推論の機能があります。
- SATからDiffusersへのモデル重み変換。
- 動画キャプションの生成。
- ファインチューニング済みLoRAアダプターのエクスポートと読み込み。
- プロンプト支援生成の実験。
- 複数のGPUでの並列推論。
CogVideo(ICLR ’23)
初期のCogVideo研究では、テキストから動画を生成するための大規模Transformer事前学習を検証しました。
CogVideoは、比較的高いフレームレートでの動画生成を実証しました。 4秒間、32フレームの例を以下に示します。
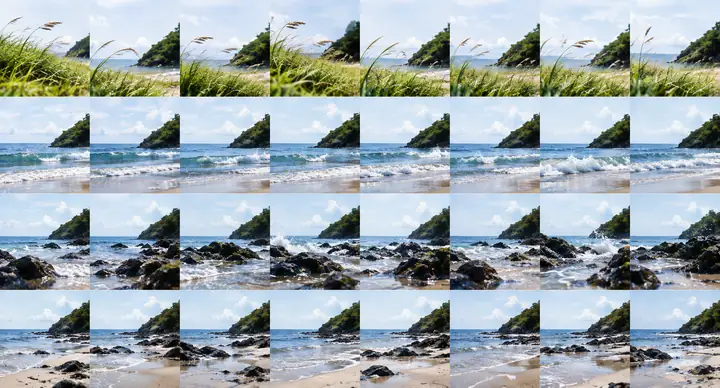
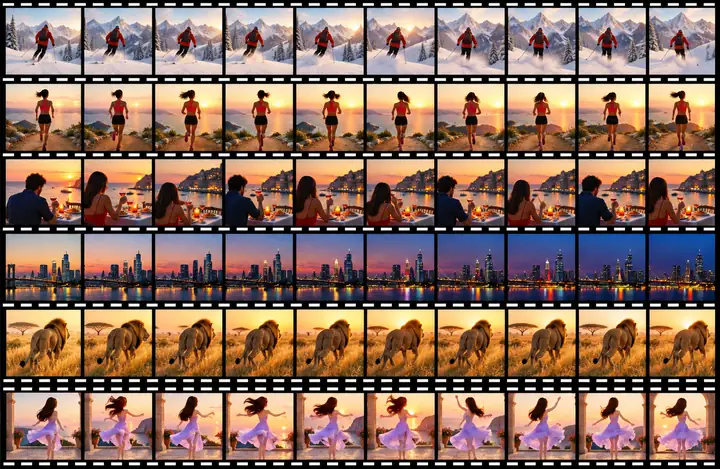
これらの例は、初期のテキストから動画への変換に関する研究を示しています。元のサンプルプロンプトは中国語で記述されていました。
引用
研究があなたの研究に役立つ場合は、関連するCogVideoXまたはCogVideoの論文を引用してください。
@article{yang2024cogvideox,
  title={CogVideoX: Text-to-Video Diffusion Models with An Expert Transformer},
  author={Yang, Zhuoyi and others},
  journal={arXiv preprint arXiv:2408.06072},
  year={2024}
}

@article{hong2022cogvideo,
  title={CogVideo: Large-scale Pretraining for Text-to-Video Generation via Transformers},
  author={Hong, Wenyi and others},
  journal={arXiv preprint arXiv:2205.15868},
  year={2022}
}
モデルライセンス
リポジトリのコードとCogVideoX-2Bモデルは、Apache 2.0ライセンスの下で公開されています。テキストから動画および画像から動画のバリエーションを含むCogVideoX-5Bモデルの重みには、別途モデルライセンスが適用されます。モデルの重みを使用する前に、適用される条件を確認してください。