cogvideox — texte et image vers vidéo
Découvrez le guide des modèles et le démarrage rapide.
Parcourez les scènes d’exemple ou consultez les ressources du projet.
Actualités du projet
- 🔥🔥 Actualité :
2025/03/24— CogKit réunit les outils d’ajustement fin et d’inférence pour les familles de modèles CogView4 et CogVideoX. - 🔥 Actualité :
2025/02/28— La prise en charge de l’inversion DDIM a été ajoutée à CogVideoX-5B et CogVideoX1.5-5B. - 🔥 Actualité :
2025/01/08— Le code d’ajustement fin LoRA basé sur Diffusers a été mis à jour avec des flux de travail utilisant moins de mémoire. - 🔥 Actualité :
2024/11/15— CogVideoX1.5 est devenu disponible dans une version de Diffusers, avec seulement de légères modifications nécessaires au code existant. - 🔥 Actualité :
2024/11/08— CogVideoX1.5 a étendu la série avec une génération en plus haute résolution de dix secondes et la prise en charge de la conversion image-vidéo à différentes résolutions. - 🔥 Actualité :
2024/10/13— Un framework d’ajustement fin sur un seul GPU pour CogVideoX-5B a été publié, avec la prise en charge de plusieurs résolutions. - 🔥 Actualité :
2024/10/10— Le rapport technique a été mis à jour avec davantage de détails sur l’entraînement et de démonstrations. - 🔥 Actualité :
2024/09/19— CogVideoX-5B-I2V a ajouté à la série la génération de vidéos conditionnée par une image, en complément de la génération texte-vidéo et de la continuation vidéo. - 🔥
2024/09/19— CogVLM2-Caption, utilisé pour décrire les données vidéo pendant l’entraînement, a été publié. - 🔥
2024/08/27— CogVideoX-5B a été publié avec des optimisations de l’inférence destinées à rendre ce modèle plus volumineux plus accessible. - 🔥
2024/08/06— Un VAE causal 3D et le premier modèle CogVideoX-2B ont été publiés en open source. - 🌱 Travaux antérieurs : Les travaux de recherche initiaux sur la génération de vidéos à partir de texte avec CogVideo ont introduit une approche de génération vidéo fondée sur un grand Transformer.
Table des matières
Accéder directement à une section :
Démarrage rapide
Optimisation des prompts
CogVideoX a été entraîné à partir de descriptions détaillées. Un prompt clair et précis peut avoir une incidence notable sur la vidéo obtenue ; décrivez le sujet, le cadre, l’action, l’éclairage et les mouvements de caméra avant d’exécuter un modèle.
SAT
Utilisez Python 3.10 à 3.12 pour les procédures documentées.
L’implémentation SAT comprend des exemples d’inférence et d’affinage pour les poids des modèles SAT. Elle est destinée à servir de point de départ aux chercheurs qui adaptent la structure du modèle.
Diffusers
Utilisez Python 3.10 à 3.12 pour les workflows documentés.
pip install -r requirements.txtL’exemple d’inférence Diffusers explique les paramètres courants de génération. L’inférence quantifiée avec Diffusers et TorchAO peut réduire les besoins en mémoire, bien que les performances réelles dépendent du matériel et de la configuration.
Galerie
CogVideoX-5B
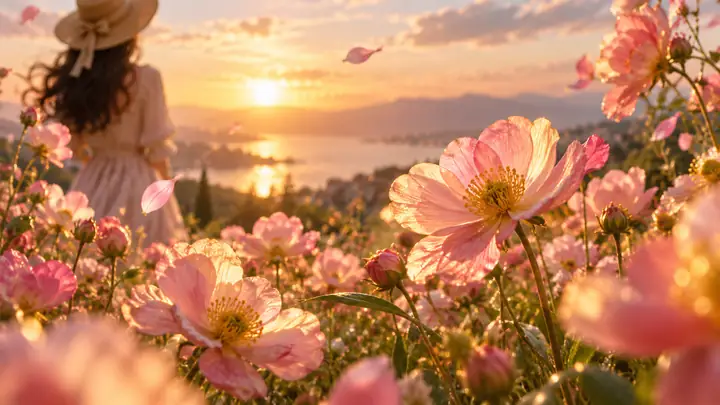
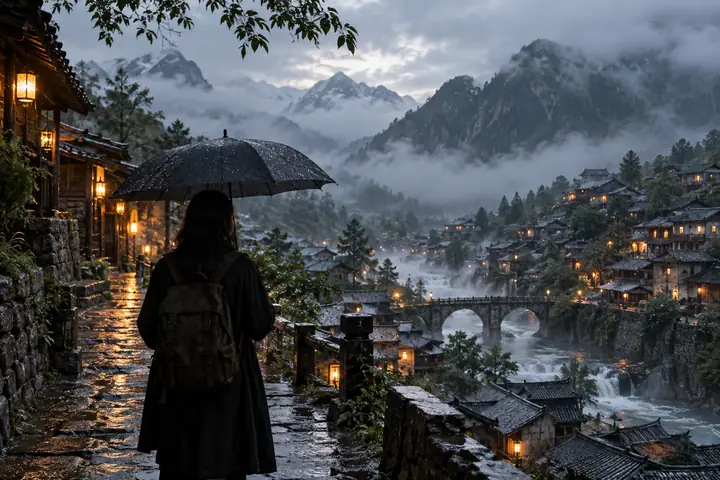
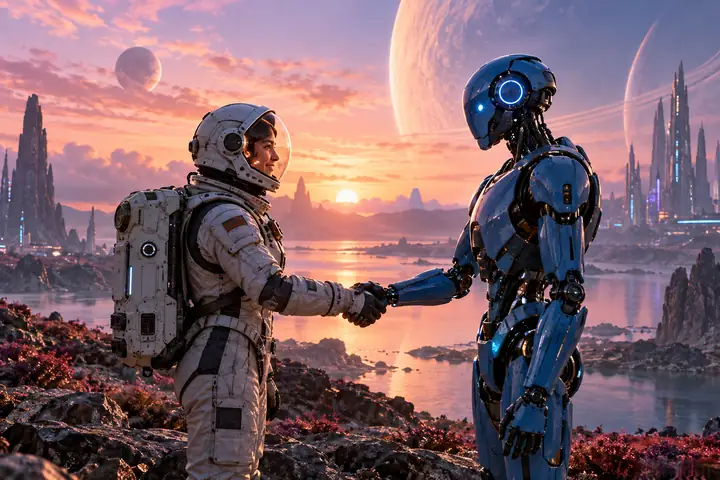
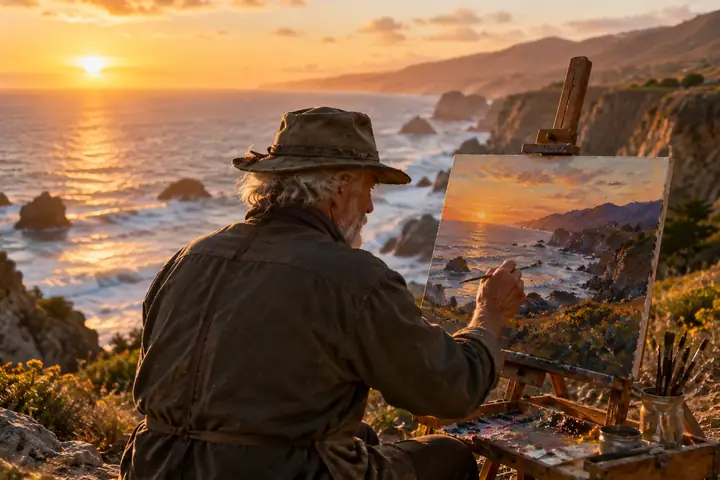
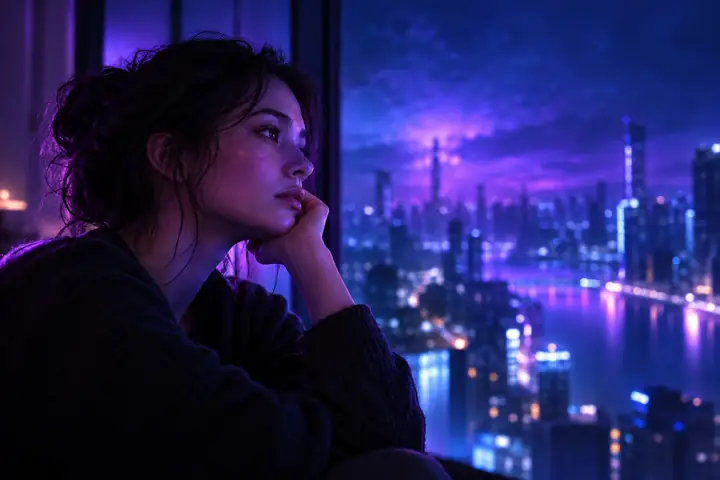
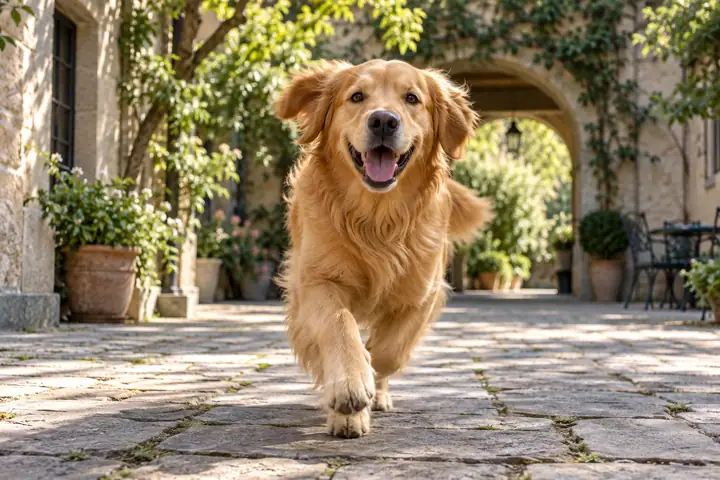
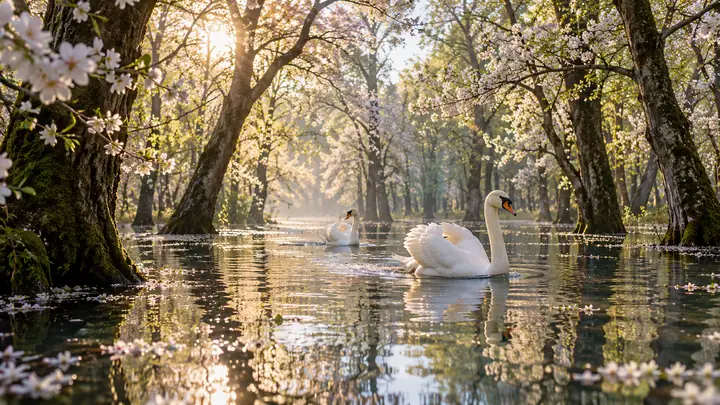
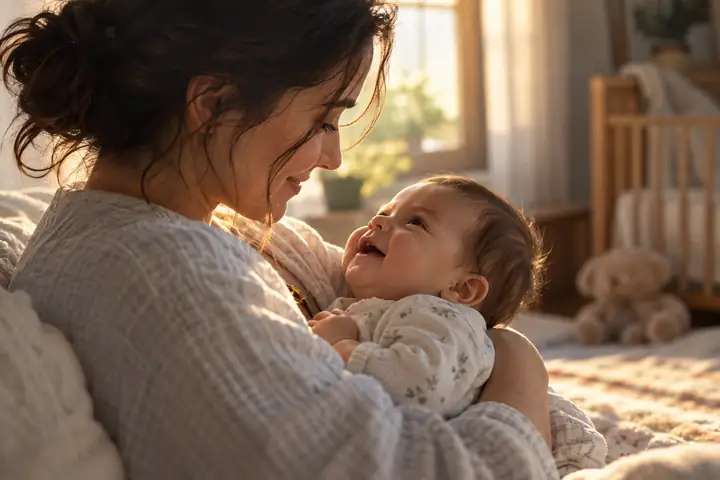
CogVideoX-2B
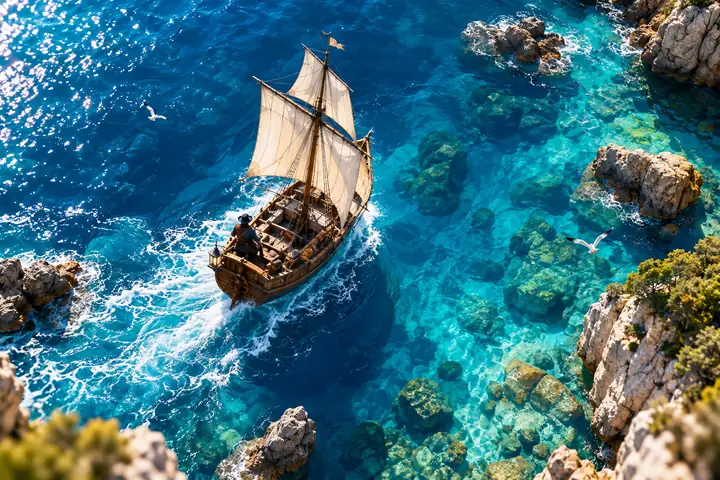
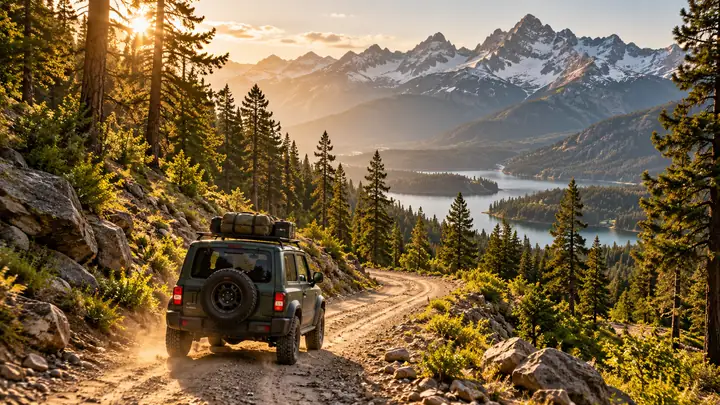
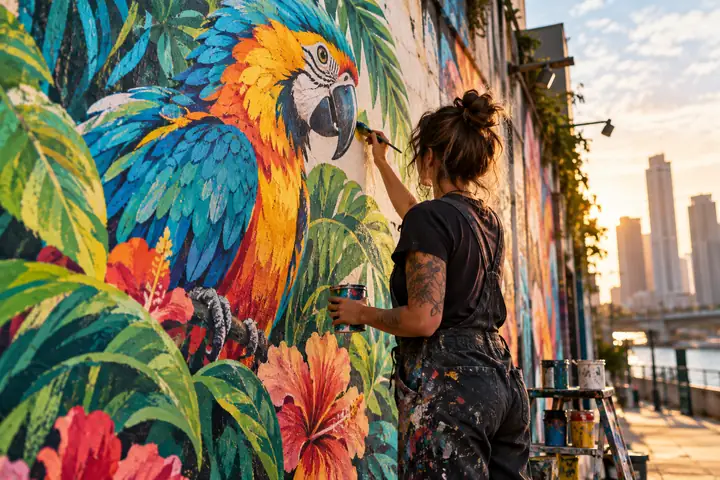
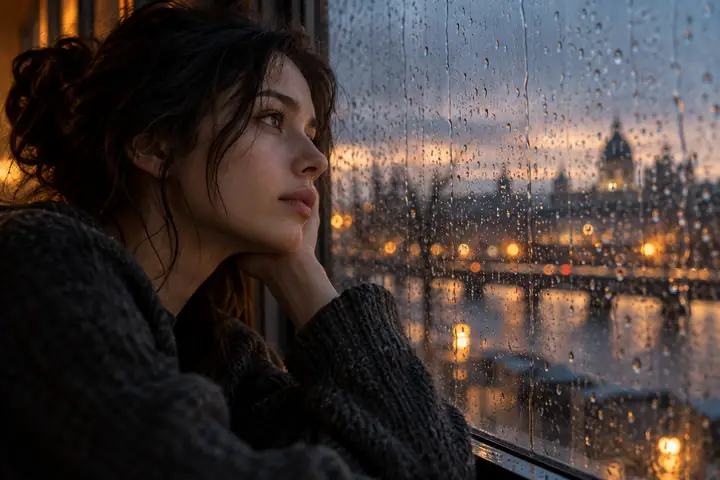
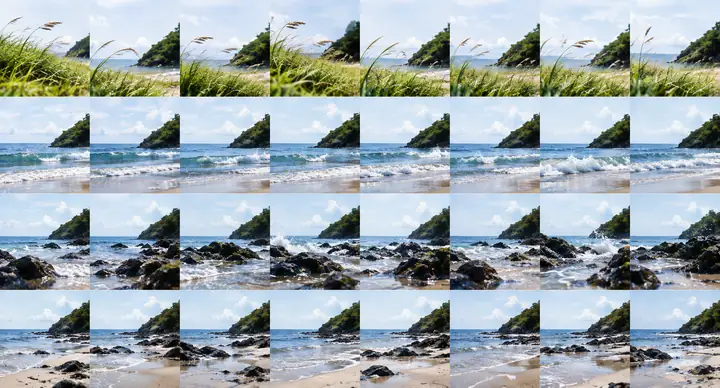
Ces images fixes illustrent les types de scènes explorées dans la galerie de modèles.
Présentation du modèle
CogVideoX est une famille open source de modèles de génération vidéo. La présentation ci-dessous compare les variantes publiées et leurs caractéristiques de génération de base.
| Nom du modèle | CogVideoX1.5-5B | CogVideoX1.5-5B-I2V | CogVideoX-2B | CogVideoX-5B |
|---|---|---|---|---|
| Date de sortie | 8 novembre 2024 | 8 novembre 2024 | 6 août 2024 | 27 août 2024 |
| Résolution vidéo | 1360 × 768 | Dimensions variables dans les limites documentées | 720 × 480 | 720 × 480 |
| Nombre d’images | 16N + 1 ; 81 par défaut | 16N + 1 ; 81 par défaut | 8N + 1 ; 49 par défaut | 8N + 1 ; 49 par défaut |
| Précision d’inférence | BF16 recommandé | BF16 recommandé | FP16 recommandé | BF16 recommandé |
| Mémoire d’un seul GPU | Dépend de l’implémentation et des optimisations | Dépend de l’implémentation et des optimisations | Dépend de l’implémentation et des optimisations | Dépend de l’implémentation et des optimisations |
| Utilisation de plusieurs GPU | Pris en charge par les workflows applicables | Pris en charge par les workflows applicables | Dépendant du workflow | Dépendant du workflow |
| Langue du prompt | English | English | English | English |
| Limite de tokens du prompt | 224 tokens | 224 tokens | 226 tokens | 226 tokens |
| Durée de la vidéo | 5 ou 10 seconds | 5 ou 10 seconds | 6 seconds | 6 seconds |
| Fréquence d’images | 16 frames / second | 16 frames / second | 8 frames / second | 8 frames / second |
| Encodage positionnel | 3d_rope_pos_embed | 3d_rope_pos_embed | 3d_sincos_pos_embed | 3d_rope_pos_embed |
| Explorer les modèles | Options du modèle | Options image vers vidéo | Options du modèle | Options du modèle |
Explication des données
- Les chiffres de mémoire publiés dépendent de l’implémentation, de l’architecture de l’appareil, de la précision et des optimisations activées. Ils ne doivent pas être considérés comme des garanties pour chaque GPU.
- Le déchargement séquentiel vers le CPU, le découpage du VAE et le carrelage du VAE peuvent réduire l’utilisation maximale de la mémoire, avec un éventuel compromis au niveau de la vitesse.
pipe.enable_sequential_cpu_offload()
pipe.vae.enable_slicing()
pipe.vae.enable_tiling()- L’inférence multi-GPU nécessite sa propre configuration ; le déchargement séquentiel vers le CPU n’est pas utilisé dans cette configuration.
- L’inférence INT8 peut convenir aux appareils disposant de moins de mémoire, mais peut être plus lente.
- cogvideox-2B a été entraîné en FP16 ; les variantes 5B ont été entraînées en BF16.
- Les outils de quantification peuvent réduire les besoins en mémoire de l’encodeur de texte, du transformateur et du VAE. Les résultats varient selon le matériel.
- Les invites d’inférence documentées sont en anglais ; les invites dans d’autres langues peuvent être traduites avant utilisation.
Liens utiles
Des projets communautaires ont exploré l’accélération, les vidéos plus longues, les interfaces alternatives, le déploiement et l’ajustement fin autour de cogvideox. Voici un aperçu des types de travaux menés dans cet écosystème :
- LeMiCa : accélération de l’inférence de diffusion basée sur le cache.
- RIFLEx-cogvideox : techniques pour prolonger la durée des vidéos générées.
- cogvideox-Fun : un pipeline prenant en charge des résolutions et des méthodes de lancement flexibles.
- CogStudio : une interface web distincte de type Gradio.
- Xorbits Inference : des flux de déploiement de modèles distribués.
- ComfyUI-cogvideoxWrapper : une intégration dans un flux de travail basé sur des nœuds.
- VideoSys : une infrastructure pour les pipelines de génération vidéo.
- AutoDL Space : un exemple de déploiement communautaire.
- Modèle de fine-tuning pour la décoration intérieure : une variante fine-tunée spécifique à un domaine.
- xDiT : une inférence évolutive sur plusieurs GPU.
- cogvideox-Interpolation : des expériences d’interpolation d’images clés.
- DiffSynth-Studio : un moteur de flux de travail fondé sur la diffusion.
- cogvideox-Controlnet : un module communautaire axé sur le contrôle.
- VideoTuna : une collection de flux de travail pour les modèles de génération vidéo.
- ConsisID : des recherches sur la cohérence de l’identité dans les vidéos générées.
- Tutoriels étape par étape : guides d’installation et d’optimisation.
Structure du projet
Le projet open source organise des exemples d’utilisation de base, d’inférence, de conversion de modèles et de fine-tuning pour la famille de modèles cogvideox.
Démarrage rapide avec Colab
Les notebooks d’exemple couvrent plusieurs points de départ :
- Génération texte-vidéo avec CogVideoX-5B.
- Inférence texte-vidéo quantifiée.
- Génération image-vidéo avec CogVideoX-5B.
- Flux de travail vidéo-vidéo avec CogVideoX-5B.
Inférence
- Démo CLI : les paramètres courants de génération et un exemple d’inférence en ligne de commande.
- Démo de quantification : configuration d’inférence du modèle utilisant moins de mémoire.
- Démo VAE : exécution séparée de l’autoencodeur vidéo.
- Démo Space : une interface avec des flux de travail facultatifs d’interpolation d’images et de super-résolution.
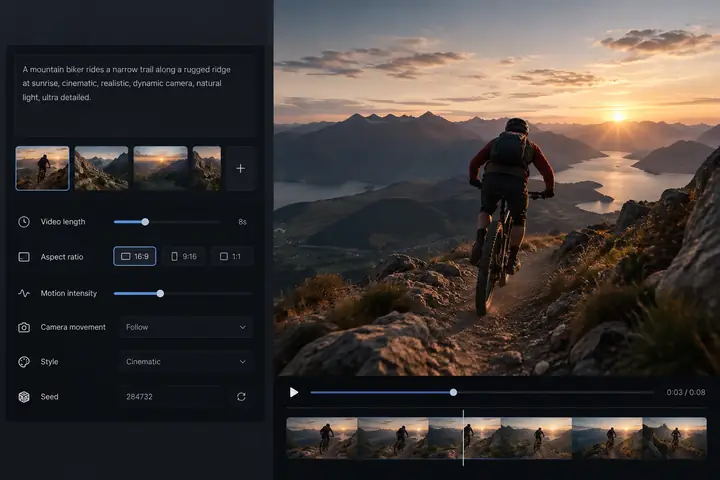
- Conversion des prompts : extension d’une courte saisie utilisateur en descriptions plus longues adaptées au modèle.
- Démo web : une interface simple dans le navigateur pour explorer la génération vidéo.
fine-tune
- Les exemples de fine-tuning décrivent le flux de travail cogvideox basé sur Diffusers.
sat
- Le dossier SAT contient des exemples d’inférence avec les poids du modèle et d’affinement pour les chercheurs.
Outils
Les outils complémentaires couvrent la conversion de modèles, le sous-titrage, la gestion des adaptateurs et l’inférence parallèle.
- Conversion des poids de modèle de SAT vers Diffusers.
- Génération de légendes vidéo.
- Exportation et chargement d’adaptateurs LoRA affinés.
- Expériences de génération assistée par invites.
- Inférence parallèle sur plusieurs GPU.
CogVideo (ICLR ’23)
Les premières recherches sur CogVideo ont étudié le préentraînement de Transformers à grande échelle pour la génération de vidéos à partir de texte.
CogVideo a démontré une génération vidéo à une fréquence d’images relativement élevée. Un exemple de quatre secondes et 32 images est présenté ci-dessous.
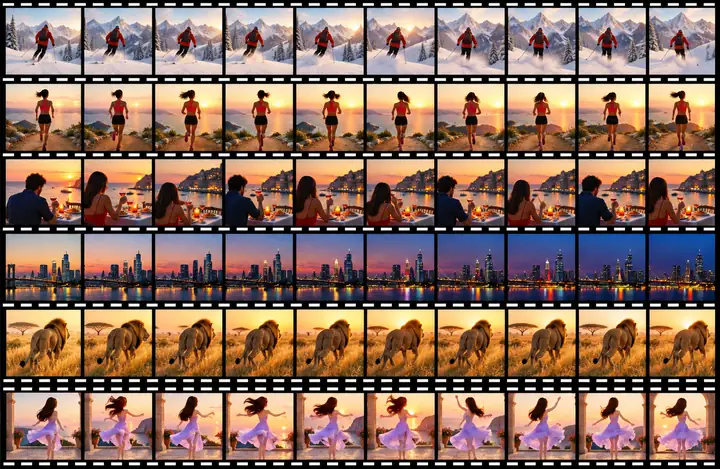
Ces exemples illustrent les premières recherches sur la génération de vidéos à partir de texte. Les invites originales des exemples étaient rédigées en chinois.
Citation
Si ces recherches sont utiles à vos travaux, veuillez citer l’article pertinent sur CogVideoX ou CogVideo.
@article{yang2024cogvideox,
  title={CogVideoX: Text-to-Video Diffusion Models with An Expert Transformer},
  author={Yang, Zhuoyi and others},
  journal={arXiv preprint arXiv:2408.06072},
  year={2024}
}

@article{hong2022cogvideo,
  title={CogVideo: Large-scale Pretraining for Text-to-Video Generation via Transformers},
  author={Hong, Wenyi and others},
  journal={arXiv preprint arXiv:2205.15868},
  year={2022}
}
Licence du modèle
Le code du dépôt et le modèle CogVideoX-2B sont publiés sous licence Apache 2.0. Les poids du modèle CogVideoX-5B, y compris les variantes de génération de texte vers vidéo et d’image vers vidéo, sont soumis à une licence de modèle distincte. Consultez les conditions applicables avant d’utiliser les poids du modèle.