cogvideox — Text und Bild zu Video
Erkunden Sie den Modellleitfaden und den Schnellstart.
Durchsuchen Sie Beispielszenen oder sehen Sie sich Projektressourcen.
Projektaktualisierungen
- 🔥🔥 Neuigkeiten:
2025/03/24— CogKit vereint Feintuning- und Inferenztools für die CogView4- und CogVideoX-Modellfamilien. - 🔥 Neuigkeiten:
2025/02/28— Unterstützung für DDIM Inverse wurde für CogVideoX-5B und CogVideoX1.5-5B hinzugefügt. - 🔥 Neuigkeiten:
2025/01/08— Der auf Diffusers basierende LoRA-Feintuning-Code wurde um speichersparendere Workflows erweitert. - 🔥 Neuigkeiten:
2024/11/15— CogVideoX1.5 wurde in einer Diffusers-Version verfügbar, wobei nur geringfügige Änderungen am bisherigen Code erforderlich waren. - 🔥 Neuigkeiten:
2024/11/08— CogVideoX1.5 erweiterte die Serie um die Generierung höher aufgelöster Videos mit einer Länge von zehn Sekunden sowie um Bild-zu-Video-Unterstützung bei variierenden Auflösungen. - 🔥 Neuigkeiten:
2024/10/13— Ein Single-GPU-Feintuning-Framework für CogVideoX-5B mit Unterstützung für mehrere Auflösungen wurde veröffentlicht. - 🔥 Neuigkeiten:
2024/10/10— Der technische Bericht wurde um weitere Trainingsdetails und Demonstrationen ergänzt. - 🔥 Neuigkeiten:
2024/09/19— CogVideoX-5B-I2V ergänzte die Serie um bildkonditionierte Videogenerierung neben Text-zu-Video und Video-Fortsetzung. - 🔥
2024/09/19— CogVLM2-Caption, das zur Beschreibung von Videodaten während des Trainings verwendet wurde, wurde veröffentlicht. - 🔥
2024/08/27— cogvideox-5B wurde mit Inferenzoptimierungen veröffentlicht, die das größere Modell leichter zugänglich machen sollten. - 🔥
2024/08/06— Ein kausaler 3D-VAE und das erste cogvideox-2B-Modell wurden als Open Source veröffentlicht. - 🌱 Frühere Arbeiten: Die ursprüngliche Text-zu-Video-Forschungsarbeit CogVideo stellte einen auf großen Transformern basierenden Ansatz zur Videogenerierung vor.
Inhaltsverzeichnis
Direkt zu einem Abschnitt springen:
Schnellstart
Prompt-Optimierung
cogvideox wurde mit detaillierten Beschreibungen trainiert. Ein klarer, präziser Prompt kann das erzeugte Video deutlich beeinflussen; beschreiben Sie das Motiv, die Umgebung, die Handlung, die Beleuchtung und die Kamerabewegung, bevor Sie ein Modell ausführen.
SAT
Verwenden Sie für die dokumentierten Arbeitsabläufe Python 3.10 bis 3.12.
Die SAT-Implementierung enthält Beispiele für Inferenz und Fine-Tuning mit SAT-Modellgewichten. Sie dient als Ausgangspunkt für Forschende, die die Modellstruktur anpassen möchten.
Diffusers
Verwenden Sie für die dokumentierten Arbeitsabläufe Python 3.10 bis 3.12.
pip install -r requirements.txtDas Diffusers-Inferenzbeispiel erläutert gängige Generierungsparameter. Quantisierte Inferenz mit Diffusers und TorchAO kann den Speicherbedarf senken, wobei die tatsächliche Leistung von der Hardware und der Konfiguration abhängt.
Galerie
CogVideoX-5B
CogVideoX-2B
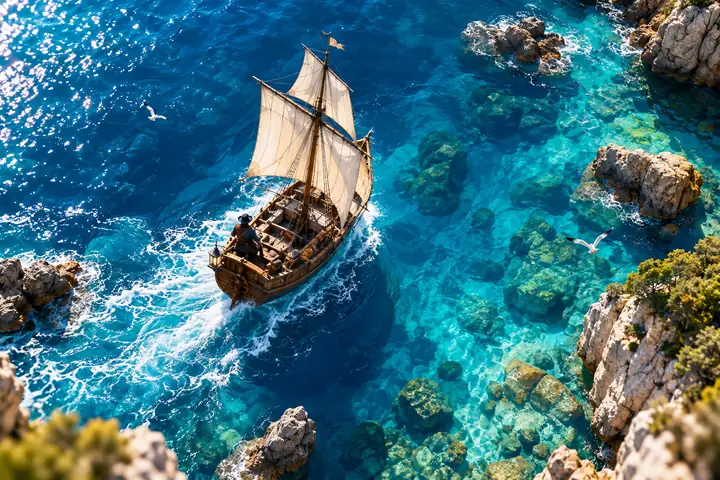
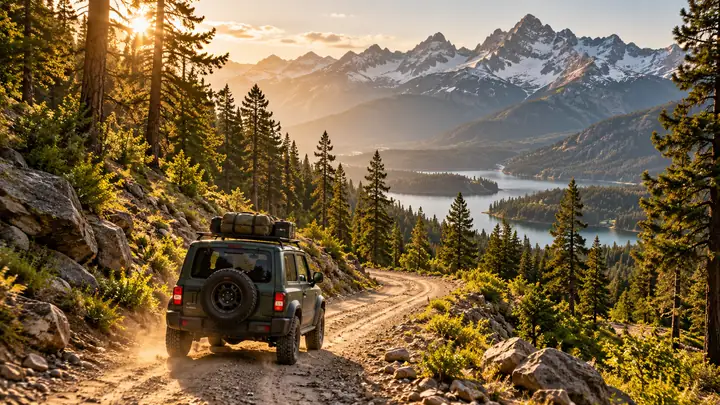
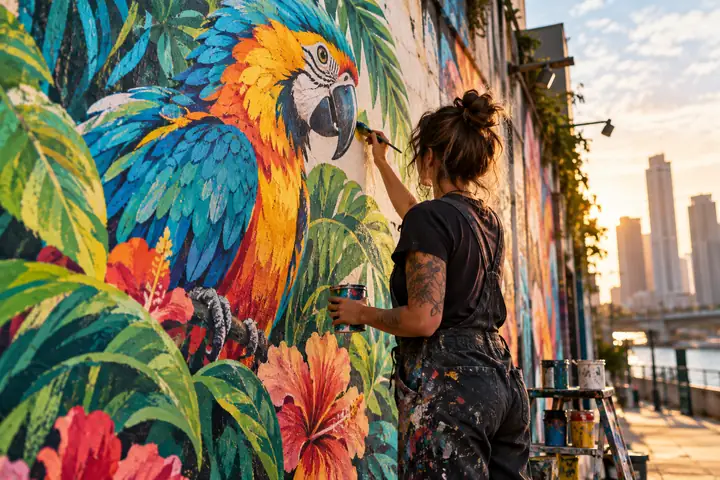
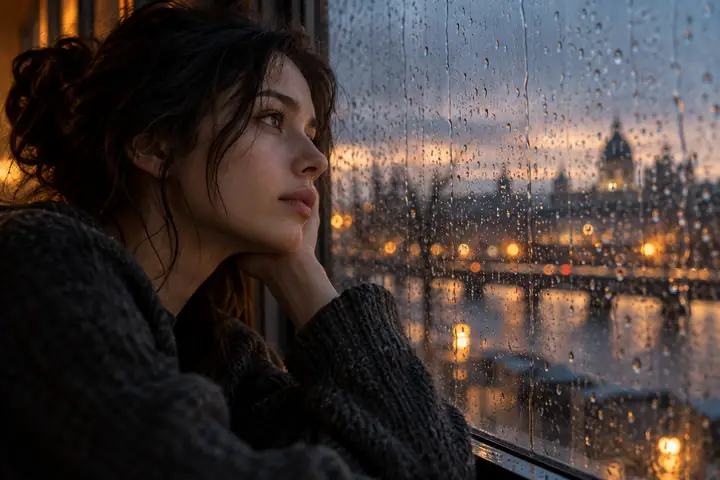
Diese Standbilder veranschaulichen die Arten von Szenen, die in der Modellgalerie gezeigt werden.
Modelleinführung
cogvideox ist eine Open-Source-Familie von Modellen zur Videogenerierung. Die folgende Übersicht vergleicht die veröffentlichten Varianten und ihre grundlegenden Generierungsmerkmale.
| Modellname | CogVideoX1.5-5B | CogVideoX1.5-5B-I2V | cogvideox-2B | cogvideox-5B |
|---|---|---|---|---|
| Veröffentlichungsdatum | 8. November 2024 | 8. November 2024 | 6. August 2024 | 27. August 2024 |
| Videoauflösung | 1360 × 768 | Variable Abmessungen innerhalb der dokumentierten Grenzen | 720 × 480 | 720 × 480 |
| Anzahl der Frames | 16N + 1; Standardwert 81 | 16N + 1; Standardwert 81 | 8N + 1; Standardwert 49 | 8N + 1; Standardwert 49 |
| Inferenzpräzision | BF16 empfohlen | BF16 empfohlen | FP16 empfohlen | BF16 empfohlen |
| Speicher einer einzelnen GPU | Hängt von der Implementierung und den Optimierungen ab | Hängt von der Implementierung und den Optimierungen ab | Hängt von der Implementierung und den Optimierungen ab | Hängt von der Implementierung und den Optimierungen ab |
| Multi-GPU-Nutzung | Unterstützt durch entsprechende Workflows | Unterstützt durch entsprechende Workflows | Workflowabhängig | Workflowabhängig |
| Prompt-Sprache | Englisch | Englisch | Englisch | Englisch |
| Prompt-Token-Limit | 224 tokens | 224 tokens | 226 tokens | 226 tokens |
| Videolänge | 5 oder 10 seconds | 5 oder 10 seconds | 6 seconds | 6 seconds |
| Bildrate | 16 frames / second | 16 frames / second | 8 frames / second | 8 frames / second |
| Positionskodierung | 3d_rope_pos_embed | 3d_rope_pos_embed | 3d_sincos_pos_embed | 3d_rope_pos_embed |
| Modelle entdecken | Modelloptionen | Optionen für Bild-zu-Video | Modelloptionen | Modelloptionen |
Datenerklärung
- Veröffentlichte Speicherangaben hängen von der Implementierung, der Gerätearchitektur, der Präzision und den aktivierten Optimierungen ab. Sie sollten nicht als Garantien für jede GPU betrachtet werden.
- Sequenzielles CPU-Offloading, VAE-Slicing und VAE-Tiling können den Spitzenbedarf an Speicher reduzieren, möglicherweise zulasten der Geschwindigkeit.
pipe.enable_sequential_cpu_offload()
pipe.vae.enable_slicing()
pipe.vae.enable_tiling()- Die Inferenz mit mehreren GPUs erfordert eine eigene Konfiguration; sequenzielles CPU-Offloading wird in dieser Anordnung nicht verwendet.
- INT8-Inferenz kann Geräte mit weniger Speicher unterstützen, läuft jedoch möglicherweise langsamer.
- cogvideox-2B wurde in FP16 trainiert; die 5B-Varianten wurden in BF16 trainiert.
- Quantisierungstools können den Speicherbedarf des Text-Encoders, des Transformers und der VAE reduzieren. Die Ergebnisse variieren je nach Hardware.
- Die dokumentierten Inferenz-Prompts sind auf Englisch; Prompts in anderen Sprachen können vor der Verwendung übersetzt werden.
Weiterführende Links
Community-Projekte haben sich im Umfeld von cogvideox mit Beschleunigung, längeren Videos, alternativen Benutzeroberflächen, Bereitstellung und Feinabstimmung beschäftigt. Hier ist eine Auswahl der Arten von Arbeiten in diesem Ökosystem:
- LeMiCa: Beschleunigung der diffusionsbasierten Inferenz durch Caching.
- RIFLEx-cogvideox: Techniken zur Verlängerung der Länge generierter Videos.
- cogvideox-Fun: eine Pipeline mit Unterstützung für flexible Auflösungen und Startmethoden.
- CogStudio: eine separate Weboberfläche im Gradio-Stil.
- Xorbits Inference: verteilte Workflows für die Modellbereitstellung.
- ComfyUI-CogVideoXWrapper: Integration in einen knotenbasierten Workflow.
- VideoSys: Infrastruktur für Pipelines zur Videogenerierung.
- AutoDL Space: ein Beispiel für die Bereitstellung durch die Community.
- Modell zur Feinabstimmung für Innenarchitektur: eine domänenspezifische feinabgestimmte Variante.
- xDiT: skalierbare Inferenz über mehrere GPUs.
- CogVideoX-Interpolation: Experimente zur Interpolation von Keyframes.
- DiffSynth-Studio: eine Engine für Diffusions-Workflows.
- CogVideoX-Controlnet: ein Community-Modul mit Fokus auf Steuerung.
- VideoTuna: eine Sammlung von Workflows für Modelle zur Videogenerierung.
- ConsisID: Forschung zur Identitätskonsistenz in generierten Videos.
- Schritt-für-Schritt-Anleitungen: Installations- und Optimierungsanleitungen.
Projektstruktur
Das Open-Source-Projekt bündelt Beispiele für die grundlegende Nutzung, Inferenz, Modellkonvertierung und Feinabstimmung der CogVideoX-Modellfamilie.
Schnellstart mit Colab
Die Beispiel-Notebooks decken mehrere Einstiegsmöglichkeiten ab:
- CogVideoX-5B-Text-zu-Video-Generierung.
- Quantisierte Text-zu-Video-Inferenz.
- CogVideoX-5B-Bild-zu-Video-Generierung.
- CogVideoX-5B-Video-zu-Video-Workflows.
Inferenz
- CLI-Demo: gängige Generierungsparameter und ein Beispiel für die Inferenz über die Kommandozeile.
- Quantisierungsdemo: Modellinferenz mit geringerem Speicherbedarf.
- VAE-Demo: den Video-Autoencoder separat ausführen.
- Space-Demo: eine Oberfläche mit optionaler Frame-Interpolation und Super-Resolution-Workflows.
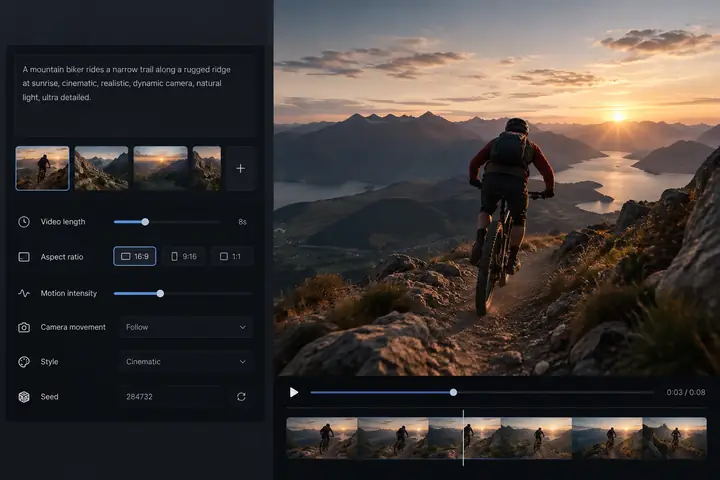
- Prompt-Umwandlung: kurze Nutzereingaben zu längeren, für das Modell geeigneten Beschreibungen erweitern.
- Web-Demo: eine einfache Browseroberfläche zum Erkunden der Videogenerierung.
finetune
- Beispiele zur Feinabstimmung beschreiben den auf Diffusers basierenden CogVideoX-Workflow.
sat
- Der SAT-Ordner enthält Beispiele für die Inferenz mit Modellgewichten und für das Fine-Tuning, die sich an Forschende richten.
Tools
Unterstützende Tools decken Modellkonvertierung, Videobeschriftung, die Handhabung von Adaptern und parallele Inferenz ab.
- Konvertierung von Modellgewichten von SAT zu Diffusers.
- Erstellung von Videobeschriftungen.
- Export und Laden von LoRA-Adaptern nach dem Fine-Tuning.
- Experimente zur promptgestützten Generierung.
- Parallele Inferenz über mehrere GPUs hinweg.
CogVideo (ICLR ’23)
Die frühere CogVideo-Forschung untersuchte das groß angelegte Vortraining von Transformern für die Text-zu-Video-Generierung.
CogVideo demonstrierte die Generierung von Videos mit vergleichsweise hoher Bildrate. Ein vier Sekunden langes Beispiel mit 32 Frames ist unten dargestellt.
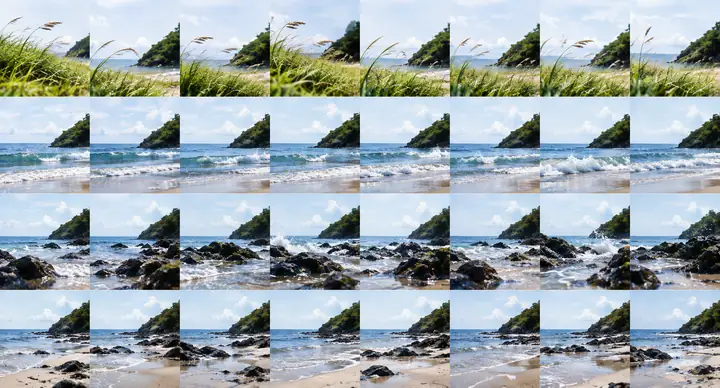
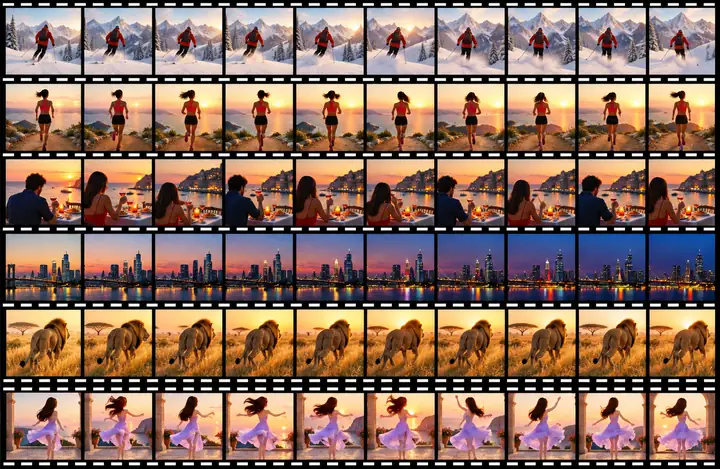
Diese Beispiele veranschaulichen die frühere Forschung zur Text-zu-Video-Generierung. Die ursprünglichen Beispiel-Prompts wurden auf Chinesisch verfasst.
Zitieren
Wenn die Forschung für Ihre Arbeit nützlich ist, zitieren Sie die entsprechende Veröffentlichung zu cogvideox oder CogVideo.
@article{yang2024cogvideox,
  title={CogVideoX: Text-to-Video Diffusion Models with An Expert Transformer},
  author={Yang, Zhuoyi and others},
  journal={arXiv preprint arXiv:2408.06072},
  year={2024}
}

@article{hong2022cogvideo,
  title={CogVideo: Large-scale Pretraining for Text-to-Video Generation via Transformers},
  author={Hong, Wenyi and others},
  journal={arXiv preprint arXiv:2205.15868},
  year={2022}
}
Modelllizenz
Der Repository-Code und das Modell cogvideox-2B werden unter der Apache 2.0-Lizenz veröffentlicht. Für die Modellgewichte von cogvideox-5B, einschließlich der Text-zu-Video- und Bild-zu-Video-Varianten, gilt eine separate Modelllizenz. Prüfen Sie die geltenden Bedingungen, bevor Sie Modellgewichte verwenden.