cogvideox — texto e imagen a video
Explora la guía del modelo y inicio rápido.
Explora escenas de ejemplo o consulta recursos del proyecto.
Actualizaciones del proyecto
- 🔥🔥 Novedades:
2025/03/24— CogKit reúne herramientas de ajuste fino e inferencia para las familias de modelos CogView4 y CogVideoX. - 🔥 Novedades:
2025/02/28— Se añadió compatibilidad con la inversión DDIM para CogVideoX-5B y CogVideoX1.5-5B. - 🔥 Novedades:
2025/01/08— El código de ajuste fino de LoRA basado en Diffusers se actualizó con flujos de trabajo que utilizan menos memoria. - 🔥 Novedades:
2024/11/15— CogVideoX1.5 pasó a estar disponible en una versión de Diffusers, con solo pequeños cambios necesarios en el código anterior. - 🔥 Novedades:
2024/11/08— CogVideoX1.5 amplió la serie con generación de mayor resolución de diez segundos y compatibilidad con imagen a video en distintas resoluciones. - 🔥 Novedades:
2024/10/13— Se publicó un marco de ajuste fino en una sola GPU para CogVideoX-5B con compatibilidad con múltiples resoluciones. - 🔥 Novedades:
2024/10/10— El informe técnico se actualizó con más detalles sobre el entrenamiento y demostraciones. - 🔥 Novedades:
2024/09/19— CogVideoX-5B-I2V añadió a la serie la generación de video condicionada por imagen, junto con la conversión de texto a video y la continuación de video. - 🔥
2024/09/19— CogVLM2-Caption, utilizado para describir datos de video durante el entrenamiento, fue publicado. - 🔥
2024/08/27— CogVideoX-5B fue publicado con optimizaciones de inferencia destinadas a hacer más accesible el modelo de mayor tamaño. - 🔥
2024/08/06— Se publicaron como código abierto un VAE causal 3D y el primer modelo CogVideoX-2B. - 🌱 Trabajos anteriores: El trabajo original de investigación de CogVideo sobre texto a video introdujo un enfoque basado en Transformer de gran tamaño para la generación de videos.
Índice
Ir a una sección específica:
Inicio rápido
Optimización de prompts
CogVideoX se entrenó con descripciones detalladas. Un prompt claro y específico puede marcar una diferencia significativa en el video resultante; describe el sujeto, el entorno, la acción, la iluminación y el movimiento de la cámara antes de ejecutar un modelo.
SAT
Usa Python 3.10 a 3.12 para los flujos de trabajo documentados.
La implementación de SAT incluye ejemplos de inferencia y ajuste fino para los pesos del modelo SAT. Está pensada como punto de partida para investigadores que adapten la estructura del modelo.
Diffusers
Utiliza Python 3.10 a 3.12 para los flujos de trabajo documentados.
pip install -r requirements.txtEl ejemplo de inferencia de Diffusers explica los parámetros de generación habituales. La inferencia cuantizada mediante Diffusers y TorchAO puede reducir los requisitos de memoria, aunque el rendimiento real depende del hardware y la configuración.
Galería
CogVideoX-5B
CogVideoX-2B
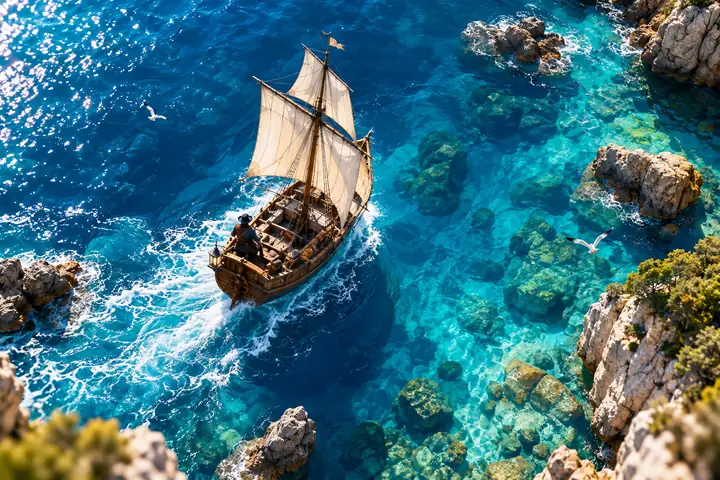
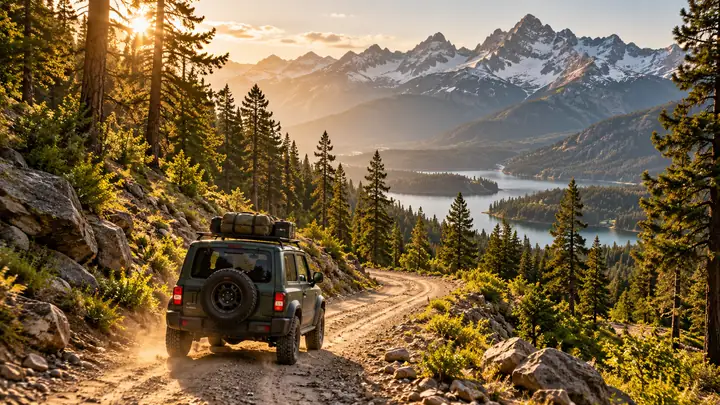
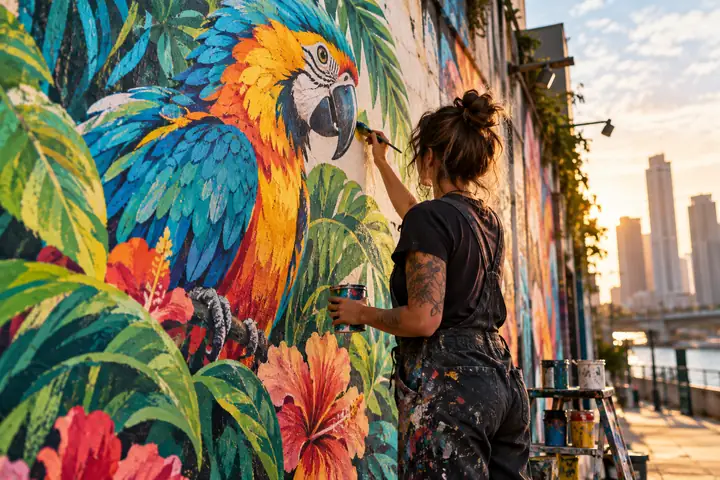
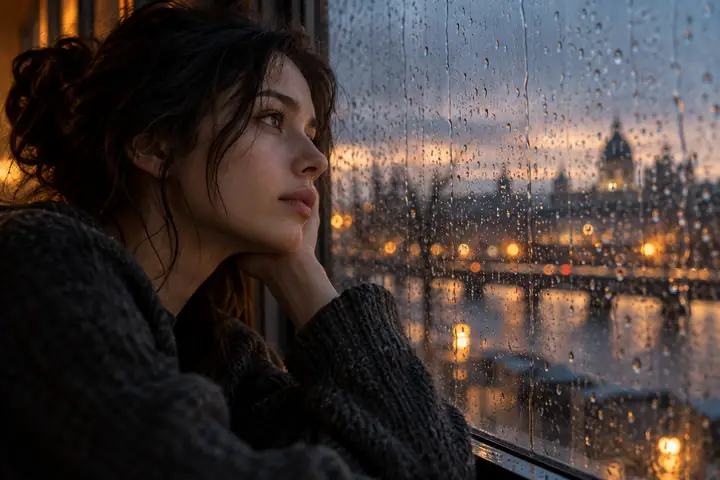
Estas imágenes fijas ilustran los tipos de escenas exploradas en la galería del modelo.
Introducción al modelo
CogVideoX es una familia de modelos de generación de vídeo de código abierto. La descripción general a continuación compara las variantes publicadas y sus características básicas de generación.
| Nombre del modelo | CogVideoX1.5-5B | CogVideoX1.5-5B-I2V | CogVideoX-2B | CogVideoX-5B |
|---|---|---|---|---|
| Fecha de lanzamiento | 8 de noviembre de 2024 | 8 de noviembre de 2024 | 6 de agosto de 2024 | 27 de agosto de 2024 |
| Resolución de video | 1360 × 768 | Dimensiones variables dentro de los límites documentados | 720 × 480 | 720 × 480 |
| Número de fotogramas | 16N + 1; predeterminado 81 | 16N + 1; predeterminado 81 | 8N + 1; predeterminado 49 | 8N + 1; predeterminado 49 |
| Precisión de inferencia | Se recomienda BF16 | Se recomienda BF16 | Se recomienda FP16 | Se recomienda BF16 |
| Memoria de una sola GPU | Depende de la implementación y las optimizaciones | Depende de la implementación y las optimizaciones | Depende de la implementación y las optimizaciones | Depende de la implementación y las optimizaciones |
| Uso de varias GPU | Compatible con los flujos de trabajo aplicables | Compatible con los flujos de trabajo aplicables | Depende del flujo de trabajo | Depende del flujo de trabajo |
| Idioma del prompt | Inglés | Inglés | Inglés | Inglés |
| Límite de tokens del prompt | 224 tokens | 224 tokens | 226 tokens | 226 tokens |
| Duración del vídeo | 5 o 10 seconds | 5 o 10 seconds | 6 seconds | 6 seconds |
| Frecuencia de fotogramas | 16 frames / second | 16 frames / second | 8 frames / second | 8 frames / second |
| Codificación posicional | 3d_rope_pos_embed | 3d_rope_pos_embed | 3d_sincos_pos_embed | 3d_rope_pos_embed |
| Explorar modelos | Opciones del modelo | Opciones de imagen a video | Opciones del modelo | Opciones del modelo |
Explicación de los datos
- Las cifras de memoria publicadas dependen de la implementación, la arquitectura del dispositivo, la precisión y las optimizaciones activadas. No deben considerarse garantías para todas las GPU.
- La descarga secuencial a la CPU, el segmentado de VAE y la división en mosaicos de VAE pueden reducir el uso máximo de memoria, con una posible compensación en la velocidad.
pipe.enable_sequential_cpu_offload()
pipe.vae.enable_slicing()
pipe.vae.enable_tiling()- La inferencia con varias GPU requiere su propia configuración; la descarga secuencial a la CPU no se utiliza en esa disposición.
- La inferencia INT8 puede adaptarse a dispositivos con menos memoria, pero puede ejecutarse más lentamente.
- cogvideox-2B se entrenó en FP16; las variantes 5B se entrenaron en BF16.
- Las herramientas de cuantización pueden reducir las necesidades de memoria del codificador de texto, el transformador y el VAE. Los resultados varían según el hardware.
- Las indicaciones de inferencia documentadas están en inglés; las indicaciones en otros idiomas pueden traducirse antes de usarse.
Enlaces útiles
Los proyectos de la comunidad han explorado la aceleración, los videos más largos, las interfaces alternativas, la implementación y el ajuste fino en torno a cogvideox. Esta es una muestra de los tipos de trabajo presentes en ese ecosistema:
- LeMiCa: aceleración de la inferencia de difusión basada en caché.
- RIFLEx-cogvideox: técnicas para ampliar la duración de los videos generados.
- cogvideox-Fun: una canalización compatible con resoluciones y métodos de lanzamiento flexibles.
- CogStudio: una interfaz web independiente al estilo de Gradio.
- Xorbits Inference: flujos de trabajo para el despliegue distribuido de modelos.
- ComfyUI-CogVideoXWrapper: integración en un flujo de trabajo basado en nodos.
- VideoSys: infraestructura para canalizaciones de generación de video.
- AutoDL Space: un ejemplo de despliegue comunitario.
- Interior Design Fine-Tuning Model: una variante ajustada específicamente para un dominio.
- xDiT: inferencia escalable en varias GPU.
- CogVideoX-Interpolation: experimentos de interpolación de fotogramas clave.
- DiffSynth-Studio: un motor de flujos de trabajo de difusión.
- CogVideoX-Controlnet: un módulo comunitario centrado en el control.
- VideoTuna: una colección de flujos de trabajo de modelos de generación de video.
- ConsisID: investigación sobre la coherencia de identidad en videos generados.
- Tutoriales paso a paso: recorridos de instalación y optimización.
Estructura del proyecto
El proyecto de código abierto organiza ejemplos de uso básico, inferencia, conversión de modelos y ajuste fino para la familia de modelos cogvideox.
Inicio rápido con Colab
Los cuadernos de ejemplo cubren varios puntos de partida:
- Generación de texto a video con cogvideox-5B.
- Inferencia de texto a video con cuantización.
- Generación de imagen a video con cogvideox-5B.
- Flujos de trabajo de video a video con cogvideox-5B.
Inferencia
- Demostración de CLI: parámetros de generación comunes y un ejemplo de inferencia desde la línea de comandos.
- Demostración de cuantización: configuración de inferencia del modelo con menor uso de memoria.
- Demostración de VAE: ejecución independiente del autocodificador de video.
- Demostración de Space: una interfaz con flujos de trabajo opcionales de interpolación de fotogramas y superresolución.
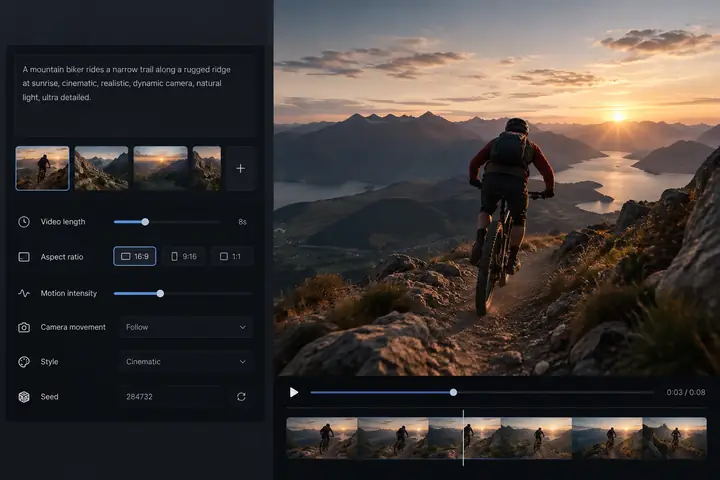
- Conversión de prompts: ampliación de una entrada breve del usuario en descripciones más largas adecuadas para el modelo.
- Demostración web: una interfaz sencilla del navegador para explorar la generación de videos.
ajuste fino
- Los ejemplos de ajuste fino describen el flujo de trabajo de cogvideox basado en Diffusers.
sat
- La carpeta SAT contiene ejemplos de inferencia y ajuste fino con pesos de modelos para investigadores.
Herramientas
Las herramientas complementarias abarcan la conversión de modelos, la generación de subtítulos, la gestión de adaptadores y la inferencia en paralelo.
- Conversión de pesos de modelos de SAT a Diffusers.
- Generación de subtítulos para vídeos.
- Exportación y carga de adaptadores LoRA ajustados.
- Experimentos de generación asistida por instrucciones.
- Inferencia en paralelo con varias GPUs.
CogVideo (ICLR ’23)
La investigación anterior de CogVideo estudió el preentrenamiento a gran escala de Transformers para generar vídeos a partir de texto.
CogVideo demostró la generación de vídeos con una frecuencia de fotogramas relativamente alta. A continuación se muestra un ejemplo de cuatro segundos y 32 fotogramas.
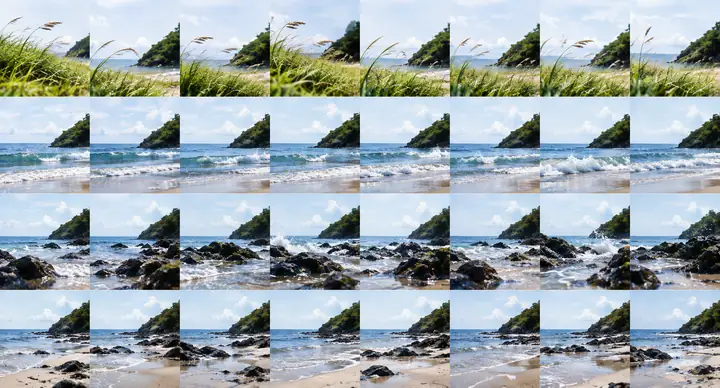
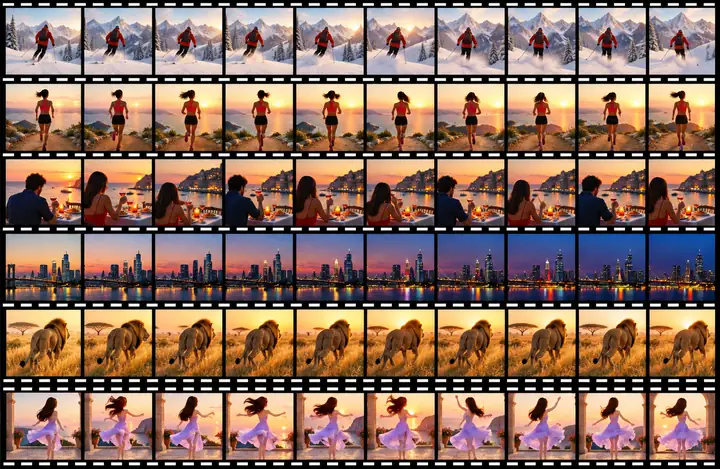
Estos ejemplos ilustran la investigación anterior sobre generación de vídeos a partir de texto. Las instrucciones originales de los ejemplos se escribieron en chino.
Cómo citar
Si esta investigación resulta útil para tu trabajo, cita el artículo correspondiente de CogVideoX o CogVideo.
@article{yang2024cogvideox,
  title={CogVideoX: Text-to-Video Diffusion Models with An Expert Transformer},
  author={Yang, Zhuoyi and others},
  journal={arXiv preprint arXiv:2408.06072},
  year={2024}
}

@article{hong2022cogvideo,
  title={CogVideo: Large-scale Pretraining for Text-to-Video Generation via Transformers},
  author={Hong, Wenyi and others},
  journal={arXiv preprint arXiv:2205.15868},
  year={2022}
}
Licencia del modelo
El código del repositorio y el modelo CogVideoX-2B se publican bajo la licencia Apache 2.0. Los pesos de los modelos CogVideoX-5B, incluidas las variantes de texto a vídeo y de imagen a vídeo, tienen una licencia de modelo independiente. Consulta las condiciones aplicables antes de usar los pesos de los modelos.