cogvideox — texto e imagem para vídeo
Explore o guia do modelo e início rápido.
Navegue por cenas de exemplo ou consulte recursos do projeto.
Atualizações do projeto
- 🔥🔥 Notícias:
2025/03/24— O CogKit reúne ferramentas de ajuste fino e inferência para as famílias de modelos CogView4 e CogVideoX. - 🔥 Notícias:
2025/02/28— O suporte à inversão DDIM foi adicionado ao CogVideoX-5B e ao CogVideoX1.5-5B. - 🔥 Notícias:
2025/01/08— O código de ajuste fino de LoRA baseado em Diffusers foi atualizado com fluxos de trabalho que usam menos memória. - 🔥 Notícias:
2024/11/15— O CogVideoX1.5 passou a estar disponível em uma versão baseada em Diffusers, com apenas pequenas alterações necessárias no código anterior. - 🔥 Notícias:
2024/11/08— O CogVideoX1.5 ampliou a série com geração em maior resolução, de dez segundos, e suporte à conversão de imagem em vídeo em várias resoluções. - 🔥 Notícias:
2024/10/13— Foi lançado um framework de ajuste fino em uma única GPU para o CogVideoX-5B, com suporte a várias resoluções. - 🔥 Notícias:
2024/10/10— O relatório técnico foi atualizado com mais detalhes de treinamento e demonstrações. - 🔥 Notícias:
2024/09/19— O CogVideoX-5B-I2V adicionou à série a geração de vídeo condicionada por imagem, além de texto para vídeo e continuação de vídeo. - 🔥
2024/09/19— O CogVLM2-Caption, usado para descrever dados de vídeo durante o treinamento, foi lançado. - 🔥
2024/08/27— O CogVideoX-5B foi lançado com otimizações de inferência destinadas a tornar o modelo maior mais acessível. - 🔥
2024/08/06— Um VAE Causal 3D e o primeiro modelo CogVideoX-2B foram disponibilizados como código aberto. - 🌱 Trabalhos anteriores: A pesquisa original do CogVideo sobre texto para vídeo introduziu uma abordagem de grande escala baseada em Transformer para geração de vídeos.
Índice
Ir para uma seção específica:
Início rápido
Otimização de prompts
O CogVideoX foi treinado com descrições detalhadas. Um prompt claro e específico pode fazer uma diferença significativa no vídeo resultante; descreva o assunto, o cenário, a ação, a iluminação e o movimento da câmera antes de executar um modelo.
SAT
Use Python 3.10 a 3.12 nos fluxos de trabalho documentados.
A implementação do SAT inclui exemplos de inferência e ajuste fino para os pesos do modelo SAT. Ela serve como ponto de partida para pesquisadores que adaptam a estrutura do modelo.
Diffusers
Use Python 3.10 a 3.12 para os fluxos de trabalho documentados.
pip install -r requirements.txtO exemplo de inferência do Diffusers explica os parâmetros comuns de geração. A inferência quantizada usando Diffusers e TorchAO pode reduzir os requisitos de memória, embora o desempenho real dependa do hardware e da configuração.
Galeria
cogvideox-5B
cogvideox-2B
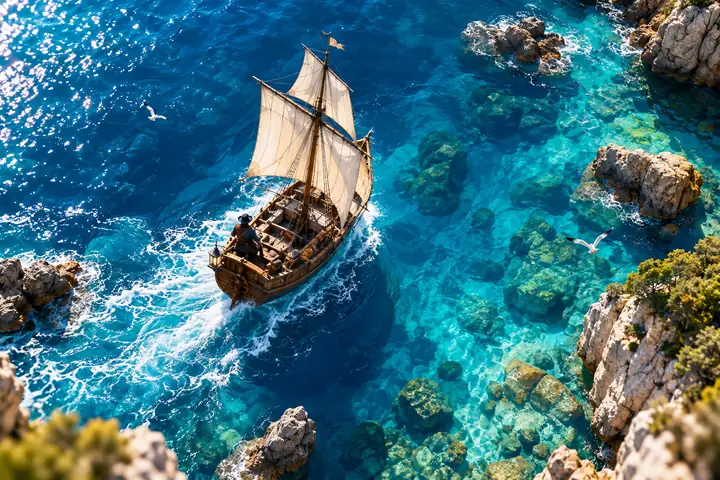
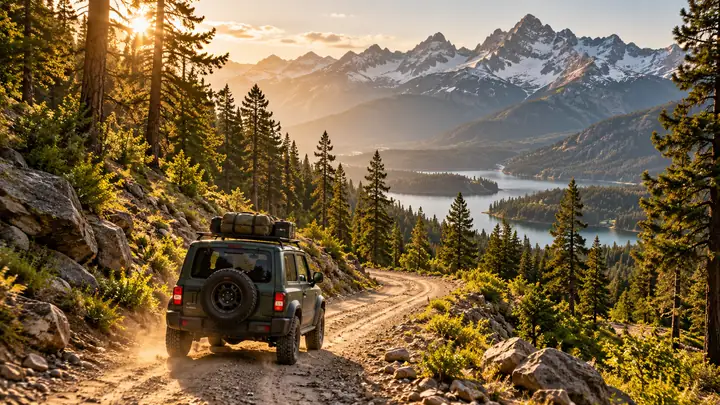
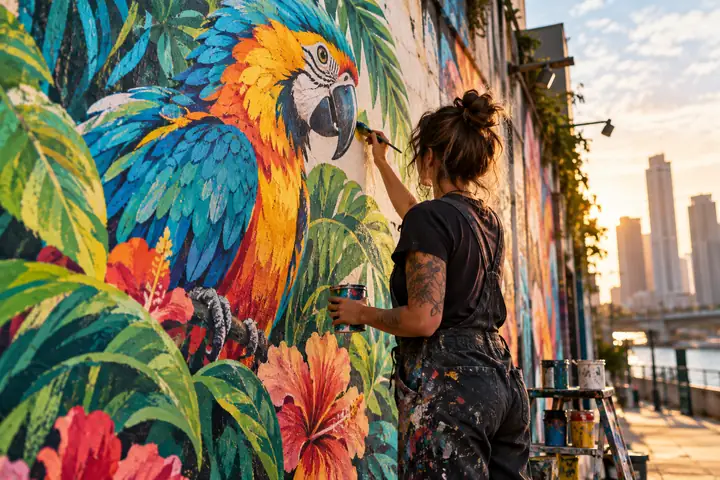
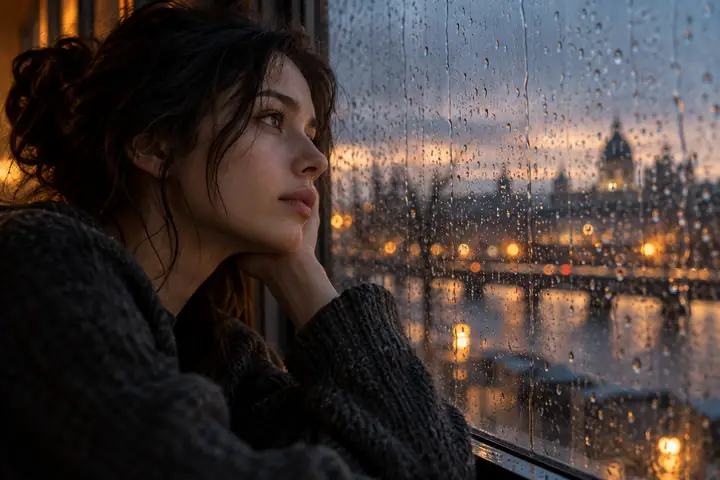
Estas imagens estáticas ilustram os tipos de cenas explorados na galeria do modelo.
Introdução ao modelo
cogvideox é uma família de modelos de geração de vídeo de código aberto. A visão geral abaixo compara as variantes publicadas e suas características básicas de geração.
| Nome do modelo | cogvideox1.5-5B | cogvideox1.5-5B-I2V | CogVideoX-2B | CogVideoX-5B |
|---|---|---|---|---|
| Data de lançamento | 8 de novembro de 2024 | 8 de novembro de 2024 | 6 de agosto de 2024 | 27 de agosto de 2024 |
| Resolução do vídeo | 1360 × 768 | Dimensões variáveis dentro dos limites documentados | 720 × 480 | 720 × 480 |
| Número de quadros | 16N + 1; padrão 81 | 16N + 1; padrão 81 | 8N + 1; padrão 49 | 8N + 1; padrão 49 |
| Precisão da inferência | BF16 recomendado | BF16 recomendado | FP16 recomendado | BF16 recomendado |
| Memória de uma única GPU | Depende da implementação e das otimizações | Depende da implementação e das otimizações | Depende da implementação e das otimizações | Depende da implementação e das otimizações |
| Uso de múltiplas GPUs | Compatível com os fluxos de trabalho aplicáveis | Compatível com os fluxos de trabalho aplicáveis | Depende do fluxo de trabalho | Depende do fluxo de trabalho |
| Idioma do prompt | Inglês | Inglês | Inglês | Inglês |
| Limite de tokens do prompt | 224 tokens | 224 tokens | 226 tokens | 226 tokens |
| Duração do vídeo | 5 ou 10 segundos | 5 ou 10 segundos | 6 segundos | 6 segundos |
| Taxa de quadros | 16 quadros / segundo | 16 quadros / segundo | 8 quadros / segundo | 8 quadros / segundo |
| Codificação posicional | 3d_rope_pos_embed | 3d_rope_pos_embed | 3d_sincos_pos_embed | 3d_rope_pos_embed |
| Explorar modelos | Opções do modelo | Opções de imagem para vídeo | Opções do modelo | Opções do modelo |
Explicação dos dados
- Os valores de memória publicados dependem da implementação, da arquitetura do dispositivo, da precisão e das otimizações ativadas. Eles não devem ser tratados como garantias para todas as GPUs.
- O descarregamento sequencial para a CPU, o fatiamento do VAE e o particionamento do VAE podem reduzir o uso máximo de memória, com uma possível redução na velocidade.
pipe.enable_sequential_cpu_offload()
pipe.vae.enable_slicing()
pipe.vae.enable_tiling()- A inferência com várias GPUs requer uma configuração própria; o descarregamento sequencial para a CPU não é usado nessa configuração.
- A inferência INT8 pode atender a dispositivos com menos memória, mas pode ser executada mais lentamente.
- O cogvideox-2B foi treinado em FP16; as variantes 5B foram treinadas em BF16.
- As ferramentas de quantização podem reduzir as necessidades de memória do codificador de texto, do transformador e do VAE. Os resultados variam conforme o hardware.
- Os prompts de inferência documentados estão em inglês; prompts em outros idiomas podem ser traduzidos antes do uso.
Links úteis
Projetos da comunidade exploraram aceleração, vídeos mais longos, interfaces alternativas, implantação e ajuste fino em torno do cogvideox. Aqui está uma amostra dos tipos de trabalho nesse ecossistema:
- LeMiCa: aceleração da inferência de difusão baseada em cache.
- RIFLEx-cogvideox: técnicas para estender a duração dos vídeos gerados.
- cogvideox-Fun: um pipeline compatível com resoluções e métodos de inicialização flexíveis.
- CogStudio: uma interface web separada no estilo Gradio.
- Xorbits Inference: fluxos de trabalho de implantação distribuída de modelos.
- ComfyUI-CogVideoXWrapper: integração a um fluxo de trabalho baseado em nós.
- VideoSys: infraestrutura para pipelines de geração de vídeo.
- AutoDL Space: um exemplo de implantação da comunidade.
- Interior Design Fine-Tuning Model: uma variante ajustada especificamente para um domínio.
- xDiT: inferência escalável em várias GPUs.
- CogVideoX-Interpolation: experimentos de interpolação de quadros-chave.
- DiffSynth-Studio: um mecanismo de fluxo de trabalho de difusão.
- CogVideoX-Controlnet: um módulo da comunidade focado em controle.
- VideoTuna: uma coleção de fluxos de trabalho de modelos de geração de vídeo.
- ConsisID: pesquisa sobre consistência de identidade em vídeos gerados.
- Tutoriais passo a passo: guias de instalação e otimização.
Estrutura do projeto
O projeto de código aberto organiza exemplos de uso básico, inferência, conversão de modelos e ajuste fino para a família de modelos CogVideoX.
Início rápido com o Colab
Os notebooks de exemplo abrangem vários pontos de partida:
- geração de texto para vídeo com o CogVideoX-5B.
- inferência quantizada de texto para vídeo.
- geração de imagem para vídeo com o CogVideoX-5B.
- fluxos de trabalho de vídeo para vídeo com o CogVideoX-5B.
Inferência
- Demonstração de CLI: parâmetros comuns de geração e um exemplo de inferência pela linha de comando.
- Demonstração de quantização: configuração de inferência de modelos com menor uso de memória.
- Demonstração de VAE: execução do autocodificador de vídeo separadamente.
- Demonstração do Space: uma interface com fluxos de trabalho opcionais de interpolação de quadros e super-resolução.
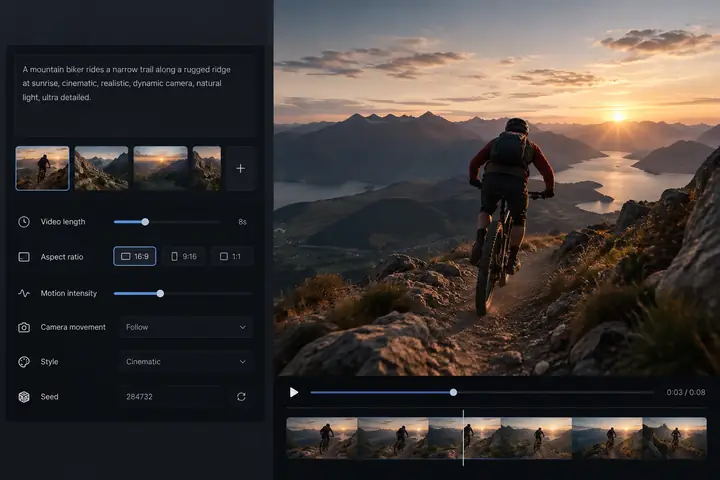
- Conversão de prompts: expansão de uma entrada curta do usuário em descrições mais longas, adequadas ao modelo.
- Demonstração web: uma interface simples no navegador para explorar a geração de vídeos.
ajuste fino
- Os exemplos de ajuste fino descrevem o fluxo de trabalho do CogVideoX baseado em Diffusers.
sat
- A pasta SAT contém exemplos de inferência e ajuste fino com pesos de modelos para pesquisadores.
Ferramentas
As ferramentas de apoio abrangem conversão de modelos, geração de legendas, gerenciamento de adaptadores e inferência paralela.
- Conversão de pesos de modelos de SAT para Diffusers.
- Geração de legendas para vídeos.
- Exportação e carregamento de adaptadores LoRA ajustados.
- Experimentos de geração com auxílio de prompts.
- Inferência paralela em várias GPUs.
CogVideo (ICLR ’23)
A pesquisa anterior sobre o CogVideo investigou o pré-treinamento em larga escala de Transformers para geração de vídeo a partir de texto.
O CogVideo demonstrou a geração de vídeos com uma taxa de quadros relativamente alta. Um exemplo de quatro segundos e 32 quadros é apresentado abaixo.
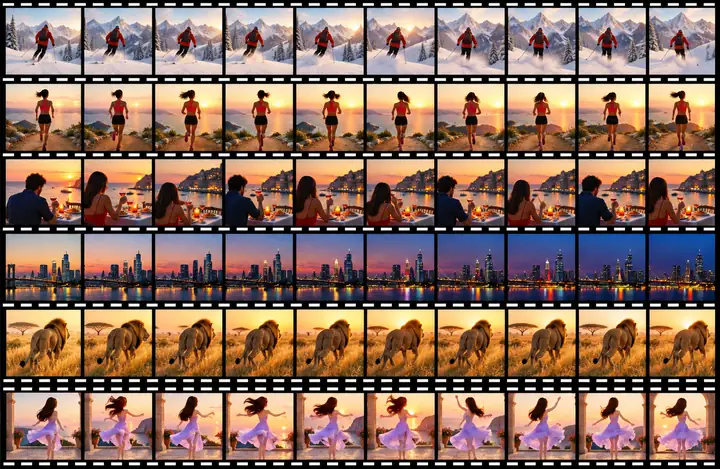
Estes exemplos ilustram a pesquisa anterior sobre geração de vídeo a partir de texto. Os prompts originais dos exemplos foram escritos em chinês.
Citação
Se a pesquisa for útil para o seu trabalho, cite o artigo relevante sobre CogVideoX ou CogVideo.
@article{yang2024cogvideox,
  title={CogVideoX: Text-to-Video Diffusion Models with An Expert Transformer},
  author={Yang, Zhuoyi and others},
  journal={arXiv preprint arXiv:2408.06072},
  year={2024}
}

@article{hong2022cogvideo,
  title={CogVideo: Large-scale Pretraining for Text-to-Video Generation via Transformers},
  author={Hong, Wenyi and others},
  journal={arXiv preprint arXiv:2205.15868},
  year={2022}
}
Licença dos modelos
O código do repositório e o modelo CogVideoX-2B são publicados sob a licença Apache 2.0. Os pesos dos modelos CogVideoX-5B, incluindo as variantes de texto para vídeo e de imagem para vídeo, têm uma licença de modelo separada. Consulte os termos aplicáveis antes de usar os pesos dos modelos.