Artiste storyboard
Commencez par une image clé et demandez un mouvement de caméra mesuré, un geste du personnage ou un mouvement de l’environnement.
Le résultat peut servir de référence de mouvement sans reconstruire toute la scène à partir de mots.
Image vers vidéo
cogvideox i2v part d’une image existante, puis utilise une consigne textuelle pour prolonger ce visuel en mouvement. Il est utile lorsque le sujet, la composition ou la première image ont déjà de l’importance.
Découvrez le modèle
I2V est la version de cogvideox conditionnée par une image : l’image source établit le point de départ visuel, tandis que le prompt décrit le mouvement, le rythme et l’atmosphère.
Quand il est utile
L’image assure une continuité visuelle qu’une demande basée uniquement sur du texte doit inventer. Cela fait de l’I2V un choix pratique pour les variations contrôlées, les tests de scène et les études de mouvement.
Commencez par une image clé et demandez un mouvement de caméra mesuré, un geste du personnage ou un mouvement de l’environnement.
Le résultat peut servir de référence de mouvement sans reconstruire toute la scène à partir de mots.
Utilisez une image fixe de campagne pour tester plusieurs directions de mouvement avant de vous engager dans un tournage ou un montage finalisé.
Vous pouvez comparer l’atmosphère et le rythme tout en gardant l’idée visuelle originale reconnaissable.
Utilisez la même image avec plusieurs prompts pour étudier comment le langage de la caméra modifie la séquence générée.
L’image de départ fixe facilite l’examen et la discussion des itérations de prompts.
Placez un chargeur d’image avant les nœuds cogvideox et gardez le conditionnement, l’échantillonnage et le décodage visibles.
Le parcours I2V est plus facile à dépanner qu’un pipeline opaque en un clic.
Séquence de travail
Un passage I2V fiable sépare la référence visuelle de l’instruction de mouvement. Gardez le prompt centré sur les changements plutôt que de répéter chaque détail déjà visible dans l’image.
Utilisez une image présentant un sujet lisible, une composition stable et suffisamment d’informations visuelles pour le mouvement souhaité. Plus la référence est forte, moins le prompt doit fournir d’explications.
Indiquez l’action, le mouvement de caméra et le rythme dans un langage direct. Par exemple, demandez un lent rapprochement de caméra et une brume qui dérive plutôt que plusieurs événements sans rapport.
Vérifiez que le sujet reste cohérent, que le mouvement correspond au prompt et que l’image reste reconnaissable. Ajustez une variable à la fois pour obtenir des comparaisons plus utiles.
Définissez vos attentes
I2V est une méthode puissante pour prolonger visuellement une image, mais elle ne garantit ni une animation exacte, ni une préservation parfaite de l’identité, ni des séquences prêtes pour la production à chaque passage.
Les petites textures, les traits du visage, le texte et les mains peuvent changer au fur et à mesure que la séquence se développe.
À faire à la place
Utilisez une référence plus nette et gardez le mouvement demandé modeste.
Un prompt peut suggérer un panoramique, une orbite ou un zoom, mais le mouvement généré peut dévier ou combiner plusieurs mouvements.
À faire à la place
Décrivez d’abord une seule action de caméra, puis affinez-la après avoir examiné le résultat.
I2V génère une séquence à partir de conditions, plutôt que de placer des images clés précises sur une timeline.
À faire à la place
Utilisez-le pour l’idéation et les études de mouvement avant le montage détaillé.
Une action prolongée peut entraîner des changements dans l’apparence du sujet, l’éclairage ou la structure de l’arrière-plan.
À faire à la place
Divisez une idée plus vaste en plans plus courts et utilisez certaines sorties comme nouvelles références.
Exemple visuel
Le changement utile ne consiste pas simplement à ajouter du mouvement. Il s’agit de préserver le principe visuel de la référence tout en introduisant une action lisible de la caméra ou du sujet.
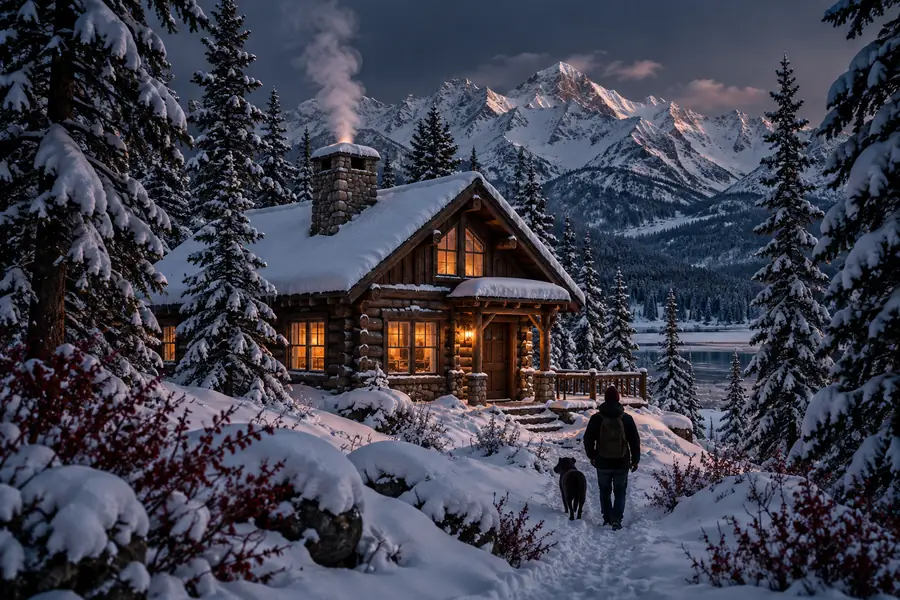
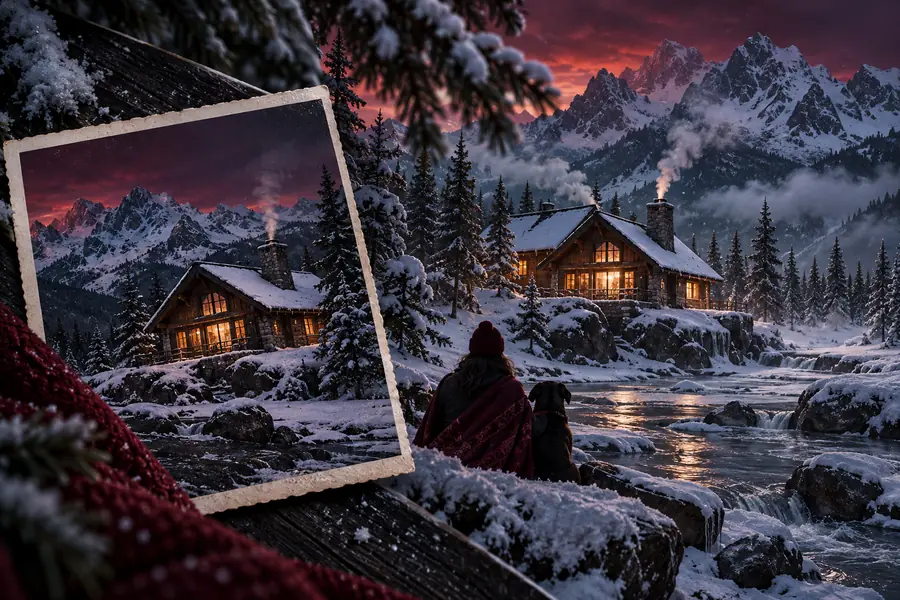
Une référence ancre la première image ; le prompt guide les changements.
Image de référenceMouvement généréÉchelle du modèle
La famille cogvideox comprend des tailles de modèles qui facilitent un choix pratique : commencez par le checkpoint et le workflow correspondant à vos ressources de calcul disponibles et à vos objectifs d’expérimentation.
Guide des variantes
Ces distinctions permettent de différencier la tâche générale d’I2V de deux chemins courants avec les modèles cogvideox et d’un format de distribution quantifié.
| Concept I2V standard | Choix du modèle ou du workflow | |
|---|---|---|
| Condition de départ | Une image fixe accompagnée d’un prompt textuel axé sur le mouvement | Un checkpoint I2V cogvideox sélectionné avec les mêmes entrées |
| Objectif principal | Transformer une idée visuelle en séquence animée | Équilibrer les objectifs de sortie avec la taille du modèle et la configuration locale |
| Échelle du modèle | Ne précise pas à lui seul le nombre de paramètres | Les références courantes incluent les variantes 2B et 5B |
| Rôle du prompt | Décrit le mouvement, le comportement de la caméra et l’atmosphère | Fournit les détails de conditionnement pour le workflow choisi |
| Rôle de référence | Définit le point de départ visuel | Est chargé via l’interface ou le pipeline sélectionné |
| Pertinence de GGUF | N’est pas un format de fichier de modèle | Peut fournir une distribution quantifiée pour les workflows pris en charge |
| Meilleur premier test | Un sujet simple avec un mouvement clairement défini | Un prompt court et reproductible utilisé avec plusieurs checkpoints |
Prêt à tester
Apportez une image de référence claire et une idée de mouvement ciblée dans le workflow cogvideox. Commencez par un test visuel court, vérifiez la continuité et affinez le prompt avant d’élargir la scène.
FAQ sur les variantes
Réponses aux questions fréquentes sur l’utilisation de cogvideox pour la génération de vidéos conditionnées par une image.
Cela désigne l’utilisation image-vers-vidéo de cogvideox. Une image fixe fournit la condition visuelle de départ, tandis qu’un prompt textuel guide le mouvement, le comportement de la caméra ou l’atmosphère.
La génération texte-vers-vidéo commence par une description écrite et doit établir visuellement la scène. La génération I2V commence par une image : la composition, l’apparence du sujet et une grande partie du contexte visuel sont donc déjà présents.
Une image nette, avec un sujet bien visible et une composition stable, constitue un bon point de départ. Des images de référence simples, avec une seule action évidente, permettent généralement de vérifier plus facilement si le mouvement généré suit l’instruction.
Il peut préserver l’idée visuelle générale, mais les détails fins peuvent changer au fil de la séquence. Considérez la préservation de l’identité et des textures comme des objectifs à évaluer plutôt que comme des garanties, surtout si le mouvement demandé est complexe.
Les désignations 2B et 5B correspondent à différentes tailles de modèles au sein de la famille cogvideox. Le choix dépend de vos ressources disponibles, de la compatibilité avec votre flux de travail et de votre préférence pour une expérimentation plus légère ou un modèle plus volumineux.