ストーリーボードアーティスト
キーフレームから始め、控えめなカメラ移動、キャラクターのジェスチャー、または環境の動きを指示します。
その結果は、シーン全体を言葉から作り直すことなく、動きの参考資料として活用できます。
画像から動画へ
cogvideox i2vは既存の画像から始め、テキストによる指示を使って、そのビジュアルを動きへと広げます。被写体や構図、最初のフレームがすでに重要な場合に役立ちます。
モデルを詳しく見る
I2Vはcogvideoxの画像条件付きモデルです。元画像がビジュアルの出発点を定め、プロンプトが動き、タイミング、雰囲気を説明します。
役立つ場面
画像がビジュアルの連続性を提供するため、テキストだけのリクエストで一から作り出す必要がありません。そのため、I2Vは制御されたバリエーション、シーンテスト、モーションスタディに実用的な選択肢となります。
キーフレームから始め、控えめなカメラ移動、キャラクターのジェスチャー、または環境の動きを指示します。
その結果は、シーン全体を言葉から作り直すことなく、動きの参考資料として活用できます。
キャンペーン用の静止画を使って、完成した撮影や編集に着手する前に、複数の動きの方向性を試します。
元のビジュアルアイデアを認識できる状態に保ちながら、雰囲気やテンポを比較できます。
同じ画像を複数のプロンプトに入力し、カメラ表現の違いが生成されたシーケンスにどのように現れるかを検証します。
開始フレームが固定されているため、プロンプトの反復結果を確認して比較しやすくなります。
CogVideoXノードの前に画像ローダーを配置し、コンディショニング、サンプリング、デコードを表示したままにします。
I2Vの構成は、不透明なワンクリックパイプラインよりもトラブルシューティングしやすくなります。
作業シーケンス
信頼性の高いI2V処理では、ビジュアルリファレンスと動きの指示を分けます。画像ですでに確認できる細部をすべて繰り返すのではなく、変化に焦点を当てたプロンプトにします。
被写体が明確で、構図が安定しており、意図する動きに十分な視覚情報を含む画像を使用します。リファレンスが強いほど、プロンプトで説明すべき内容は少なくなります。
アクション、カメラの動き、テンポを直接的な言葉で記述します。たとえば、無関係なイベントをいくつも指定するのではなく、ゆっくりとしたプッシュインと漂う霧を求めます。
被写体の一貫性が保たれているか、動きがプロンプトと一致しているか、画像が認識可能な状態を維持しているかを確認します。より有用な比較を行うため、一度に1つの変数を調整します。
期待値を設定する
I2Vはビジュアルを継続させる手法として強力ですが、毎回の処理で正確なアニメーション、完全なアイデンティティの保持、またはプロダクション品質の映像が保証されるわけではありません。
シーケンスの進行中に、小さなテクスチャ、顔の特徴、テキスト、手などが変化する場合があります。
代わりにできること
より鮮明な参照画像を使用し、指定する動きを控えめにしてください。
プロンプトでパン、オービット、ズームを指定できますが、生成された動きがずれたり、複数の動きが組み合わさったりする場合があります。
代わりにできること
まずはカメラの動きを1つだけ説明し、結果を確認してから調整してください。
I2Vはタイムライン上に正確なキーフレームを配置するのではなく、条件付けに基づいてシーケンスを生成します。
代わりにできること
詳細な編集の前に、アイデアの検討や動きの研究に使用してください。
長時間のアクションでは、被写体の外観、照明、背景の構造に変化が生じる場合があります。
代わりにできること
大きなアイデアを短いショットに分割し、選択した出力を新しい参照画像として使用してください。
ビジュアル例
重要な変化は、単に動きを加えることではありません。参照画像のビジュアル上の前提を維持しながら、カメラまたは被写体の動きをわかりやすく導入することです。
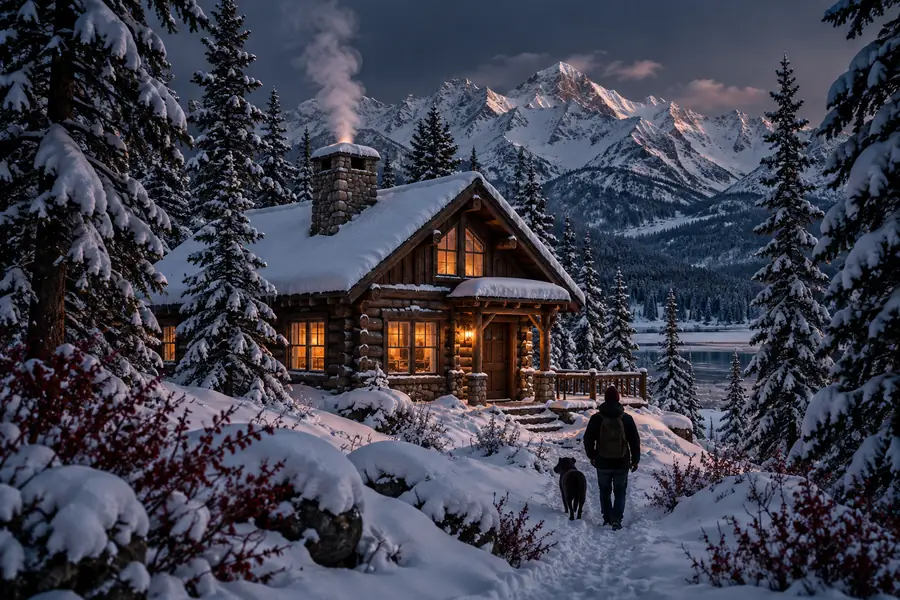
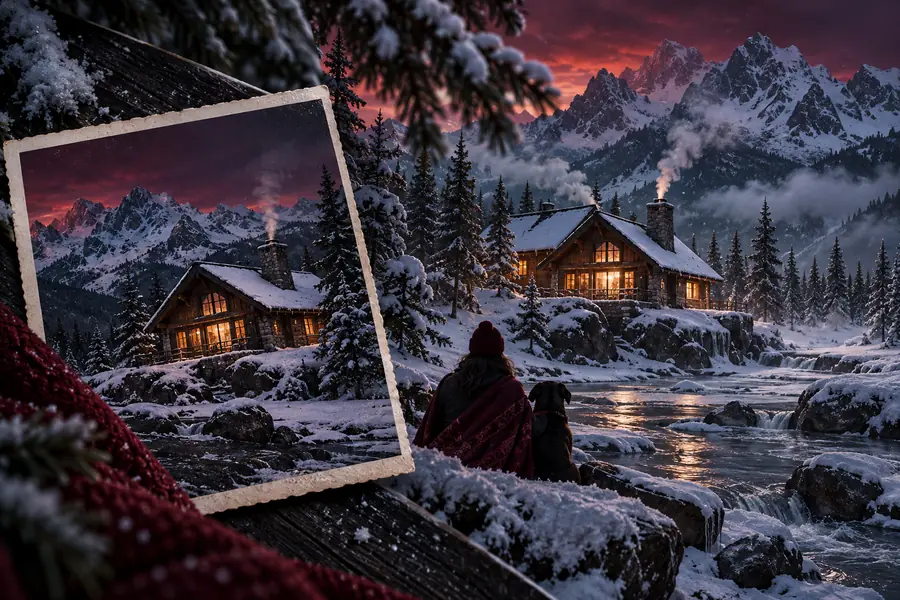
参照画像が最初のフレームの基準となり、プロンプトが変化の内容を導きます。
参照画像生成された動きモデルの規模
cogvideoxファミリーには複数のモデル規模があります。利用可能な計算資源と実験の目的に合ったチェックポイントとワークフローから始めると、実用的な選択ができます。
バリエーションガイド
これらの違いを押さえると、一般的なI2Vタスク、代表的な2つのcogvideoxモデルの選択肢、量子化された配布形式を区別できます。
| 標準的なI2Vの概念 | モデルまたはワークフローの選択 | |
|---|---|---|
| 開始条件 | 静止画像と動きに焦点を当てたテキストプロンプト | 選択したcogvideox I2Vチェックポイントと同じ入力 |
| 主な目的 | 視覚的なアイデアを動きのあるシーケンスに発展させる | 出力の目標とモデル規模、ローカル環境のバランスを取る |
| モデル規模 | それ自体はパラメータ数を指定しない | 一般的には2Bと5Bのバリエーションが挙げられる |
| プロンプトの役割 | 動き、カメラの挙動、雰囲気を説明します | 選択したワークフローのコンディショニングの詳細を提供します |
| 参照の役割 | 視覚的な開始点を定義します | 選択したインターフェースまたはパイプラインを通じて読み込まれます |
| GGUFとの関連性 | モデルファイル形式ではありません | 対応するワークフロー向けに量子化済みディストリビューションを提供できます |
| 最初に試すのに最適 | 明確な動きが1つあるシンプルな被写体 | チェックポイント間で使用する、短く再現性のあるプロンプト |
テストの準備完了
明確な参照画像と、焦点を絞った1つの動きのアイデアをcogvideoxワークフローに取り込みます。短い視覚テストから始め、連続性を確認してから、シーンを拡張する前にプロンプトを調整します。
バリアントに関するよくある質問
画像条件付き動画生成にcogvideoxを使用する際のよくある質問への回答です。
cogvideoxのimage-to-video用途を指します。静止画像が視覚的な開始条件を提供し、テキストプロンプトが動き、カメラの挙動、または雰囲気を導きます。
Text-to-videoは文章による説明から始まり、シーンを視覚的に構築する必要があります。I2Vは画像から始まるため、構図、被写体の外観、そして視覚的なコンテキストの多くがすでに用意されています。
被写体が読み取りやすく、構図が安定した明瞭な画像が、良い出発点になります。明確な動作が1つあるシンプルな参照画像なら、生成された動きが指示に沿っているかを判断しやすくなります。
全体的なビジュアルのイメージは維持できますが、シーケンスが進むにつれて細部が変化する場合があります。特に要求する動きが複雑な場合は、人物や物体の同一性、質感の維持を保証ではなく評価すべき目標として捉えてください。
2Bと5Bという名称は、cogvideoxファミリー内の異なるモデル規模を示しています。実際の選択は、利用できるリソース、ワークフローのサポート状況、軽量な実験を好むか、より大きなチェックポイントを好むかによって決まります。